登录社区云,与社区用户共同成长
邀请您加入社区
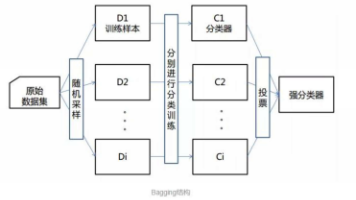
集成学习是将多个基学习器(基础模型)进行组合训练,最终形成一个强学习器的机器学习方法,核心思想是“三个臭皮匠,顶个诸葛亮”——通过多个简单模型的协同,实现比单一模型更优越的学习性能。随机森林是以决策树为基分类器的Bagging集成模型,通过对训练数据和特征进行双重随机采样,构建多棵相互独立的决策树,最终通过多数投票(分类任务)或均值(回归任务)得到模型输出。其核心是“随机”+“森林”:随机保证了树
摘要:本文介绍了AdaBoost算法中样本权重更新的核心公式和计算步骤。公式中,$D_t(x)$表示样本权重,$a_t$为模型权重,通过指数规则调整预测正确/错误样本的权重(乘以$e^{-a_t}$或$e^{a_t}$),并用归一化因子$Z_t$保证权重总和为1。计算步骤包括初始等权重分配、计算$Z_t$和更新权重。举例展示了3个样本的权重更新过程:预测错误的样本权重增加,正确的减少,最终归一化。
Boosting和Bagging作为集成学习中的两大核心算法,分别从不同的角度对模型进行优化。Boosting通过迭代训练和样本权重调整,逐步提升模型的准确性;而Bagging则通过并行训练和模型聚合,降低模型的方差,提升泛化能力。在实际应用中,选择哪种算法取决于数据特征和业务需求。希望通过本文的详细解析,读者能够更好地理解这两种算法的原理与应用,并在实际项目中做出合适的选择。
本文主要介绍了集成学习的基本概念和3类不同的集成学习框架。包括自举聚合与随机森林、集成学习器和提升算法。各个框架各有优劣,面对不同的任务和条件限制时,我们应当根据具体情况选择合适的集成学习算法。
决策树是一种常见的机器学习算法,用于分类和回归任务。它的工作原理是通过一系列的判断条件来对数据进行分割,直到达到某个终止条件在实际应用中,决策树通常需要配合剪枝技术来提高其在未知数据上的泛化能力。此外,决策树也可以作为集成学习方法(如随机森林、梯度提升树)的一部分,以提高模型的性能总的来说,随机森林是决策树的一种扩展,它通过集成多个决策树来提高预测性能和模型的稳定性这个实例展示了如何使用Pytho