登录社区云,与社区用户共同成长
邀请您加入社区
摘要:OpenClaw生态未内置Hadoop/Hive专用技能,因其企业级特性难以通用化。建议通过组合基础技能实现操作:1)使用tmux/session-logs管理长时任务;2)通过shell/exec执行HDFS/YARN/Hive命令;3)利用github/file-manager管理脚本文件。可串联成工作流或开发CustomSkill封装常用操作,但需注意安全风险,避免使用第三方技能,采用
本文介绍Paxos共识算法作为分布式系统领域的一种经典一致性协议,其核心在于解决多节点环境下达成共识的难题。Paxos通过Proposer、Acceptor和Learner等角色协作,实现对提案的提议、接受和学习过程,确保即使在部分节点故障或网络分区的情况下,系统仍能维持数据一致性和可用性。
摘要:本文提出从Hadoop数据湖(Hive/Impala)到AI决策的落地方法,采用四步走策略:1)构建统一数据底座,确保数据质量;2)建立可复用特征工程体系;3)实现模型训练与评估自动化;4)部署低延迟推理服务。重点强调特征一致性、闭环反馈机制和业务场景落地,建议从高价值场景入手,避免"大而全"方案。通过将传统大数据平台与现代AI工程结合,可低成本构建持续进化的智能决策系统
本文介绍了如何搭建Eureka Server服务注册中心,并将其应用于微服务架构中。主要内容包括:创建Eureka Server子模块,引入相关依赖,完善启动类与配置文件;将product-service注册到Eureka;在order-service中实现服务发现,通过DiscoveryClient获取服务实例进行远程调用。文章还对比了Eureka与Zookeeper的区别,展示了Eureka作
小贴士:如果有防火墙,需要按端口清单放行:ZK(2181)、Kafka(9092)、Hadoop(9870/8088)、HBase(16010)、Spark(7077/8080)、Flink(8081)。做什么:下载→设置 JAVA_HOME→写 4 个配置→格式化→启动→验证。做什么:下载→配置 masters/workers→启动→跑示例。做什么:下载→改监听地址→初始化存储→启动→发消息测试
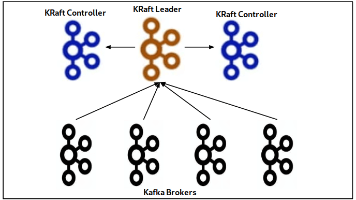
Apache Kafka作为分布式流处理平台的领导者,长期以来依赖ZooKeeper进行集群协调和元数据管理。然而,这种架构带来了额外的复杂性和运维负担。随着KIP-500的提出和实现,Kafka正在逐步摆脱对ZooKeeper的依赖,转向使用内置Raft协议实现的KRaft模式。本文将深入探讨Kafka无ZooKeeper架构(KRaft)的原理、配置方法和运维实践。
Eureka、Zookeeper和Nacos在服务发现和注册中心领域各有特点,选择使用哪种服务发现和注册中心需要根据具体的业务场景和需求来决定。
springCloud服务注册与发现Eureka、Zookeeper 、Consule
ruok命令的输出仅仅只能表明当前服务器是否在运行,准确的说是2181端口打开着,同时四字命令执行流程正常,但不能代表ZooKeeper服务器是否运行正常。wchp命令和wchc命令非常类似,也是用于输出当前服务器上管理的Watcher的详细信息,不同点在于wchp命令的输出信息以节点路径为单位进行归组。srvr命令和stat命令的功能一致,唯一的区别的是srvr不会将客户端的连接情况输出,仅仅输
选择合适的服务注册与发现工具需要综合考虑项目需求、团队技术栈、生态环境等因素。Etcd适合对一致性要求高、对功能相对简单的场景;Zookeeper适合需要高可靠性、丰富功能的场景;Consul适合需要全面的服务治理能力的场景;Nacos适合需要易用性、功能丰富、生态良好的场景。小型项目:优先考虑Etcd或Nacos,易于上手,社区活跃。大型复杂项目:优先考虑Consul或Zookeeper,功能全
需要注意的是,kafka作为一个支持多生产者多消费者的架构,再写入消息时允许多个生产者写道同一个partition,但是消费者读取的时候一个partition仅允许一个消费者消费,但一个消费者可以消费多个partition。partition的数量决定了组成topic的log的数量, 因此推荐partition的数量要大于同时允许的consumer数量,要小于等于集群broker的数量。offse