登录社区云,与社区用户共同成长
邀请您加入社区
作者:WeeJot|标签:TensorFlow, BERT, 模型部署, Docker, 微服务在AI工程化落地的过程中,模型部署往往是最具挑战性的环节之一。本文将手把手带你完成BERT模型在TensorFlow Serving上的完整部署流程,涵盖Docker容器化、REST/gRPC API调用、性能调优等实战要点,助你快速构建生产级的AI推理服务。
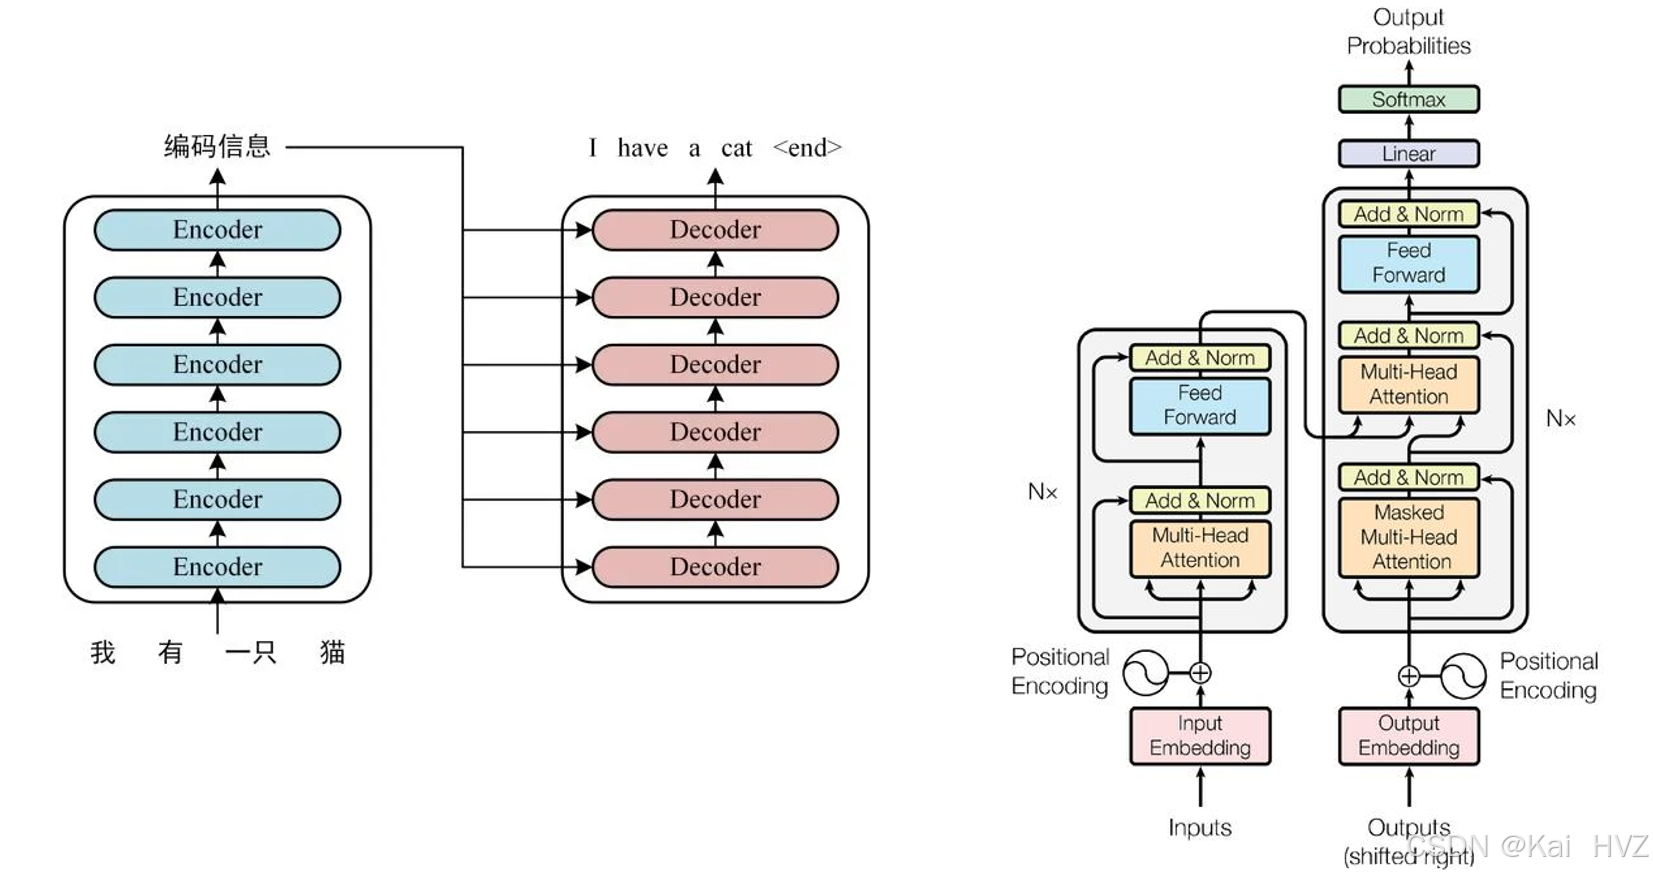
BERT是一种基于Transformer的预训练语言模型,采用双向掩码语言模型(MLM)进行训练,能生成深层次的双向语义表征。其创新性地通过[CLS]和[SEP]等特殊标记处理单句和多句输入,结合词嵌入、位置嵌入和段落嵌入作为输入特征。BERT在下游任务中仅需微调输出层即可取得优异效果,在11项NLP任务中刷新了最佳成绩。研究表明,BERT能有效捕捉上下文语义关系,在中医命名实体识别等任务中表现突
本文介绍了在SNLI数据集上微调预训练BERT模型进行自然语言推断的方法。通过加载小版本BERT,构建包含多层感知机的分类器,处理文本对数据,并进行训练优化,最终实现序列级文本分类任务,提升推断准确性。
✅BERT 分类上下文有硬上限:512 tokens❌ 超过就只能截断或切分短 chunk + 多标签分类是最优解🚫 不要迷信“CLS 能看全文”
BERT为自然语言处理提供通用解决方案,微调时只需加全连接层。本文介绍了其在单文本分类、文本对分类或回归、文本标注和问答等任务上的应用及微调方法。
本文介绍了BERT模型微调的全过程。首先设置HuggingFace环境变量指定模型和数据集存储路径,然后下载bert-base-chinese预训练模型和ChnSentiCorp中文情感分析数据集。通过Python代码实现了数据清洗、分词编码、模型训练和评估等步骤,最终获得85%的测试准确率。训练完成后将微调后的模型保存到本地,并与原始BERT模型进行对比测试,展示了情感分类效果。整个过程涵盖了从
本文在WikiText-2上预训练小型BERT,展示损失变化,并演示用预训练BERT表示文本及验证其上下文敏感性。
本文系统性梳理了 BERT 模型的结构与预训练过程,从理论到实战,完整复现了 **BERT 模型的微调流程**,并结合优化实验,探索了模型在小样本任务中的表现与调参策略。
BERT(Bidirectional Encoder Representations from Transformers)是一种基于Transformer架构的预训练语言模型,通过掩码语言模型(MLM)和下一句预测(NSP)任务实现深度双向语义理解。其核心创新在于双向上下文建模,突破了传统单向语言模型的局限。本文详细介绍了BERT的算法原理、实现步骤及训练流程,包括文本预处理、模型架构、训练策略和
BERT是2018年提出的基于Transformer的双向自编码语言模型。其核心由12层Transformer组成,采用特殊输入格式([CLS]文本1[SEP]文本2[SEP]),融合词/块/位置三种嵌入表示。预训练包含两大任务:1)改进的掩码语言模型(MLM),通过15%掩码比例和动态替换策略解决预训练-微调不一致问题;2)下一句预测(NSP)任务,构建二分类任务学习文本间关系。进阶优化包括整词
BERT(Bidirectional Encoder Representations from Transformers)是由 Google 在 2018 年提出的预训练语言模型框架,其核心思想是通过双向 Transformer 编码器学习深层语言表征,在自然语言处理(NLP)领域具有里程碑意义。
用更多生的例子一文说清BERT与Transform以及现在的Gpt、Claude、Deepseek这些模型到底是什么区别以及它们的应用场景。
本文通过实际案例演示了如何利用 Deepseek R1 模型来优化传统 BERT 模型在情感分析任务中的表现,这极大的提高了我们工作的效率,无需为优化模型苦恼,Deepseek R1可以帮你扩宽思路;最后我将蓝耘云智算的注册链接贴出来,不想麻烦的,或者只想体验一下模型的小伙伴可以试试~注册链接:https://cloud.lanyun.net//#/registerPage?
自然语言处理 (NLP) 是人工智能的一个领域,旨在使机器能够理解文本数据。NLP 研究由来已久,但直到最近,随着大数据和更高计算处理能力的引入,它才变得更加突出。随着 NLP 领域的规模越来越大,许多研究人员都试图提高机器理解文本数据的能力。经过大量的进步,许多技术在 NLP 领域被提出并应用。本文将比较 NLP 领域中处理文本数据的各种技术。本文将重点讨论 RNN、Transformers 和