爬虫科普:小白也能玩爬虫(二)
书接上回,本篇将继续基于小白的视角去探索爬虫,想要了解之前的内容的话可以去看看我之前的博文爬虫科普:小白也能玩爬虫(一)-CSDN博客
第三步:我是小白可以直接上手写爬虫吗?
1.先来尝试爬HTML
好了,之前我们爬了一组链接,但是呢? 它的输出是这样的
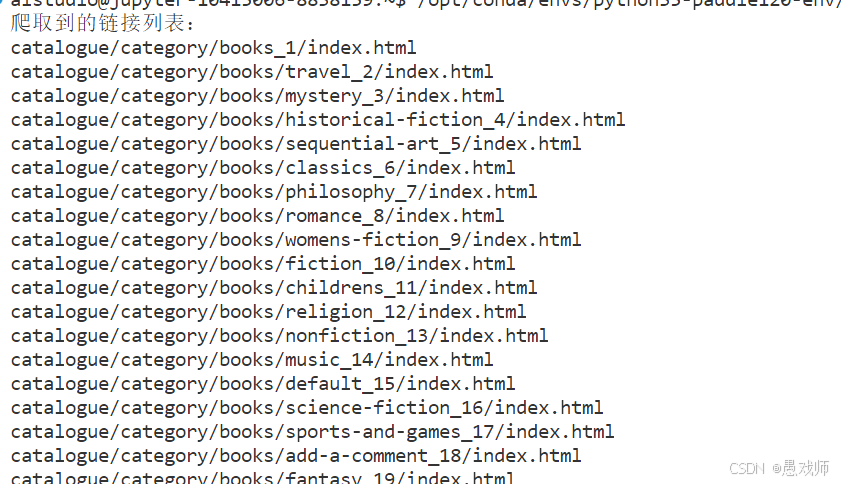
我感觉这很不方便阅读,尤其是数据量很大的情况下,你觉的呢? 欧克,接下来让我们一起去优化一下
再次确认自己的需求是什么?
我需要的是什么呢?是这些看不懂的东西吗?当然不是,那我要什么呢?
第一步:明确核心需求(用生活场景类比)
想象你在整理书签
- 你有一堆网页链接,就像收藏了不同网站的书签
- 每个书签需要两个基本信息:
- 名字(如"学校官网")
- 具体地址(如"http://school.com")
- 目标:把这些信息整齐地记在笔记本上,像课程表一样清晰
第二步:拆解技术本质(转换到编程领域,元组+列表来实现存储数据)
表格 = 数字化的笔记本
| 字段名 | 类比解释 | 技术实现 |
|---|---|---|
| 链接名称 | 书签的备注标签 | 从HTML提取的文本内容 |
| 跳转链接 | 书签指向的实际网址 | 从<a href>提取的URL |
为什么是用元组+列表来实现存储数据而不是其他的呢?
极简版解释(假设链接是不变的)元组+列表来实现存储数据而不是其他的呢?
1. 元组 = 便签纸
特点:写好后内容无法修改
- 作用:固定存储每个链接的两个核心信息
("新闻首页", "http://news.com") # 就像一张写死的便签2. 列表 = 便签本
特点:可以随时增删页面
- 作用:集中管理所有便签纸
[
  ("新闻", "http://news.com"),      # 第一张便签
  ("博客", "http://blog.com"),      # 随时追加新便签
  ("购物", "http://shop.com")       # 不想要了也能撕掉
]
为何这样设计?
需求
实现方法
示例场景
防止误改
元组不可变
保证已存的链接不会意外变乱
动态更新
列表可自由增删
新增链接直接append即可
快速操作
列表支持循环遍历
批量导出所有链接到文件
第三步:解决关键问题(把想法变成现实)
1. 如何给链接起名字?
- 方案:抓取
<a>标签内的文字<a href="/news">校园新闻</a> <!-- 提取"校园新闻"作为名称 -->
2. 如何获取完整链接?
- 问题:有些链接是
/news(不完整) - 方案:像拼积木一样拼接基础域名
base_url = "http://example.com"
relative_link = "/news"
full_url = base_url + relative_link  # 得到http://example.com/news
3. 如何避免重复记录?
- 检查机制:像检查作业是否写过一样
seen_links = set()
if new_link not in seen_links:
    seen_links.add(new_link)
    # 存储到表格
第四步:具体代码示例(Python实现)
import requests as rq
from bs4 import BeautifulSoup as bs
import csv
from urllib.parse import urljoin
# 1. 发送请求获取网页内容
response = rq.get('http://books.toscrape.com')
response.encoding = "utf-8"
html = response.text

# 2. 解析HTML内容,提取所需信息
soup = bs(html, 'lxml')

#3. 定位侧边栏列表容器
sidebar_list = soup.select_one(".sidebar .nav-list")  # 仅匹配 class="nav-list"
# print(sidebar_list)

# 4. 提取所有超链接
links=[]
seen=set()
base_url = "http://books.toscrape.com/"
if sidebar_list:
    for a_tag in sidebar_list.find_all("a"):
        href = a_tag.get("href")
        name=a_tag.text.strip()
        full_url = urljoin(base_url, href)
        if href  not in  seen:
            seen.add(href)
            links.append((name,full_url))

#5.写入CSV(表格的数字化形式)
with open('links.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f,delimiter=':')
    writer.writerow(['链接名称', '跳转地址'])  # 表头
    writer.writerows(links)
这部分代码改动并不多,重写了四和五的代码,目前可以理解吗?不理解也没关系,让我们一起去看看这写的是什么东西。
4. 提取超链接
links=[]#c(name+full_url)
seen=set()#集合去重
base_url = "http://books.toscrape.com/"| 代码 | 快递站类比 | 作用 |
|---|---|---|
links=[] | 准备空的快递筐 | 存储最终要发出的有效包裹(链接数据) |
seen=set() | 包裹登记簿(用印章快速查找) | 集合(set) 的哈希查找比列表更快,防止重复记录相同快递单号(href),就是去重 |
base_url | 快递站统一前缀地址 | 类似"北京市朝阳区+",用于补全客户填写的相对地址(如"小区3栋201") |
for a_tag in sidebar_list.find_all("a"):
    href = a_tag.get("href")  # 取快递单号
name = a_tag.text.strip() # 撕下客户手写的模糊备注并修剪| 操作 | 现实问题 | 编程意义 |
|---|---|---|
find_all("a") | 分拣区混杂着非包裹物品 | 精确筛选<a>标签,就像只处理贴有快递单的箱子 |
a_tag.get("href") | 有些单号被污损看不清 | 用.get()方法安全获取属性,即使没有href也不会报错(返回None) |
.strip() | 客户备注写歪了有留白 | 去除文字前后多余空格/换行符,就像把皱巴巴的备注贴整齐 |
full_url = base_url + href  # 拼接完整地址
if href not in seen:        # 检查是否已登记
    seen.add(href)          # 盖章标记已处理
links.append((name, full_url)) # 装入快递筐| 潜在风险 | 类比场景 | 优化建议 |
|---|---|---|
| href为绝对路径 | 客户填写了完整地址 | 用urljoin(base_url, href)自动处理,避免base_url + href产生http://...http://... |
| 特殊字符 | 地址含#号等特殊符号 | 对href进行URL编码:urllib.parse.quote(href) |
| 名称重复但URL不同 | 不同人写同一名字不同地址 | 用full_url作为去重依据更安全(原代码用href可能漏判) |
5. 写入CSV(装车发货)
with open('links.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f, delimiter=':')  # 定制包装箱
    writer.writerow(['链接名称', '跳转地址'])  # 贴分类标签
writer.writerows(links) # 批量装车| 参数 | 物流知识 | 影响 |
|---|---|---|
delimiter=':' | 用冒号代替逗号分隔 | 如果链接名称本身含英文冒号(如"时间:2023"),会导致CSV解析错误 |
newline='' | 统一包装箱缝隙标准 | 避免Windows自动添加\r\n造成空行,让不同系统换行符统一为\n |
encoding='utf-8' | 支持中文货运单 | 若用Excel打开出现乱码,需改为utf-8-sig |
第三步:多想一步
Q1: 为什么用set()而不用list查重?
→ 就像快递站用扫码枪(set的哈希查找)比翻纸质清单(list遍历)快100倍,尤其处理上万包裹时。
Q2: 为什么不用base_url + href?
→ 假设href是完整网址(如http://external.com),拼接结果会变成http://books.toscrape.com/http://external.com,正确做法是用urljoin智能拼接:
from urllib.parse import urljoin
full_url = urljoin(base_url, href)
Q3: 数据中出现特殊符号怎么办?*
→ 像处理易碎品一样特殊包装:
import csv
# 对名称和URL中的冒号进行转义
writer = csv.writer(f, delimiter=':', quoting=csv.QUOTE_ALL)最终输出示例(links.csv)
链接名称:跳转地址
Books:"http://books.toscrape.com/catalogue/category/books_1/index.html"
Travel:"http://books.toscrape.com/catalogue/category/books/travel_2/index.html"
看看结果,如下:
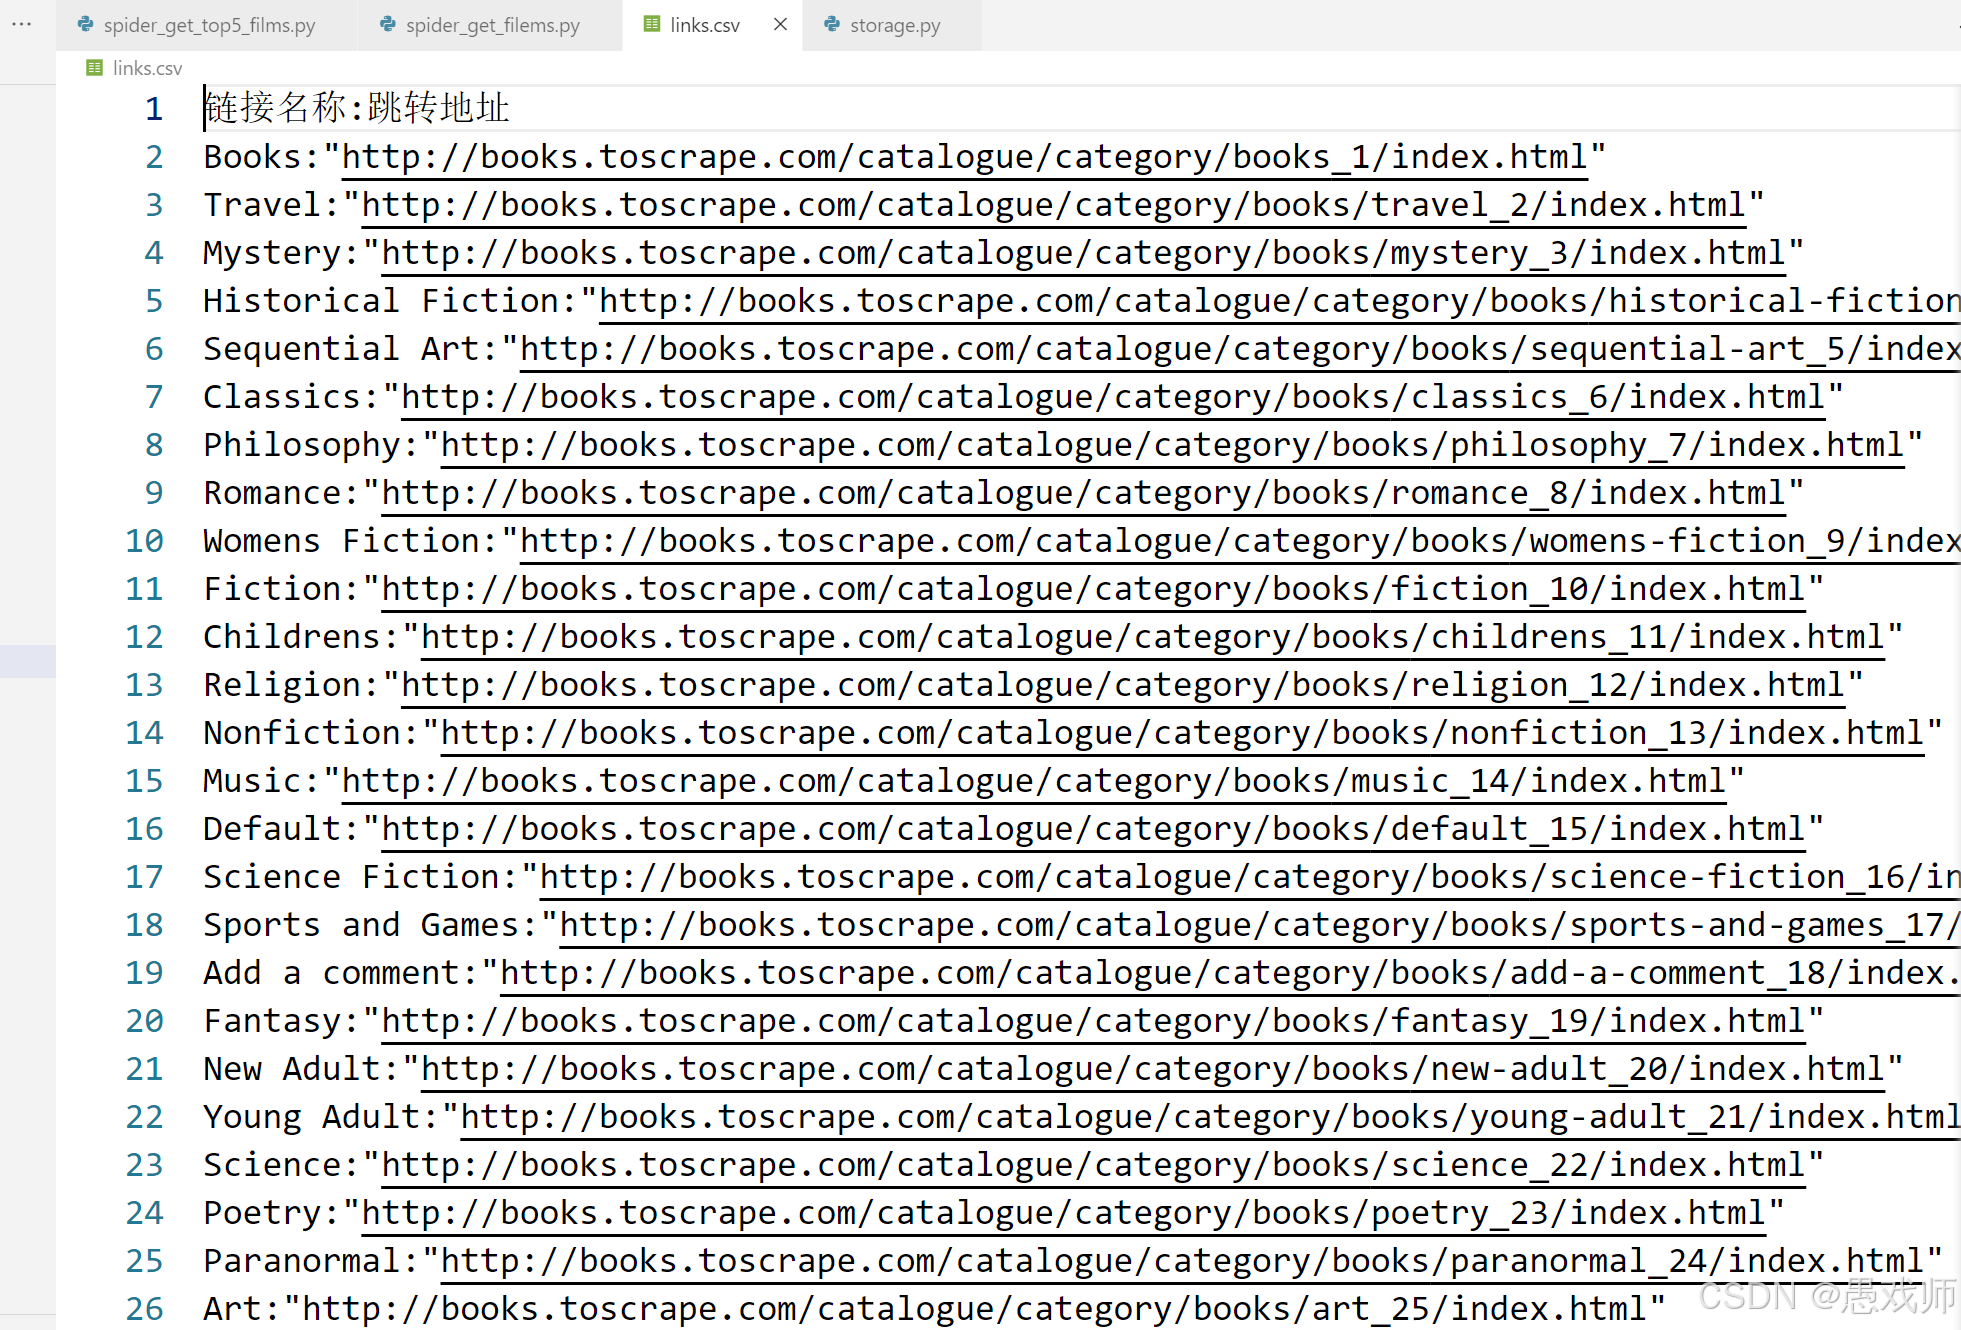
欧克,很不错了
2.爬个图片
请看图
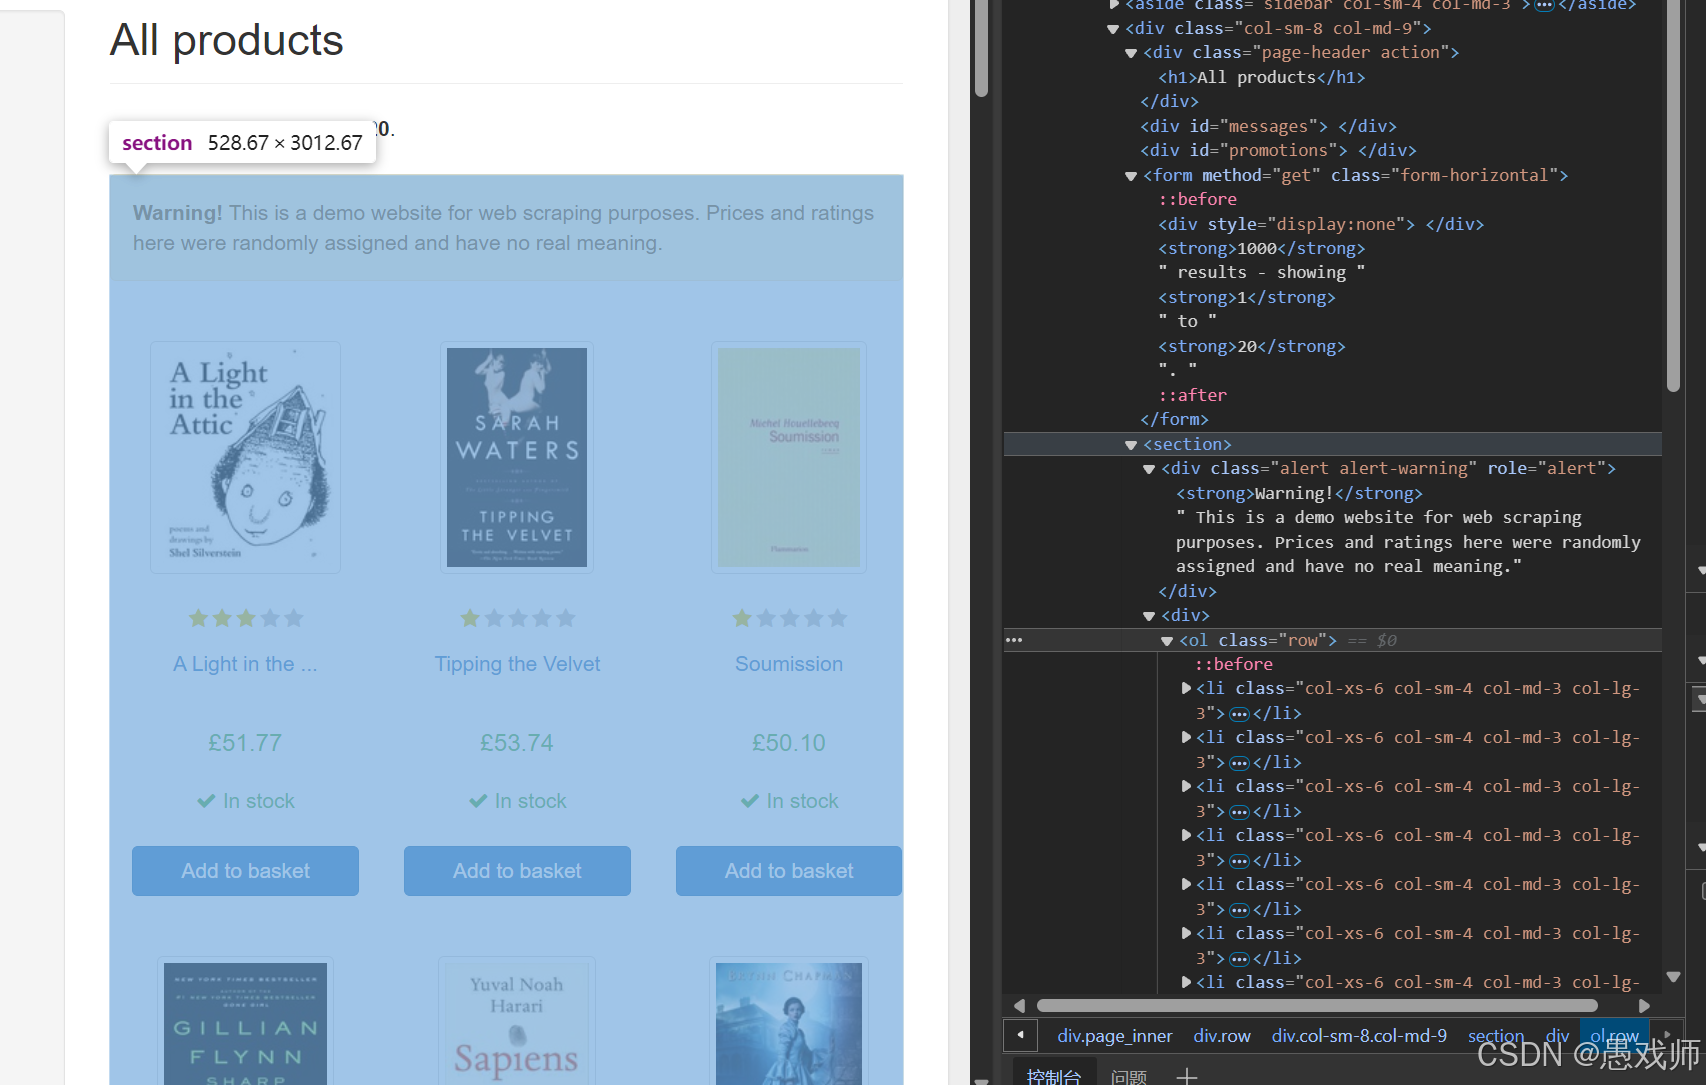
HTML结构如下:
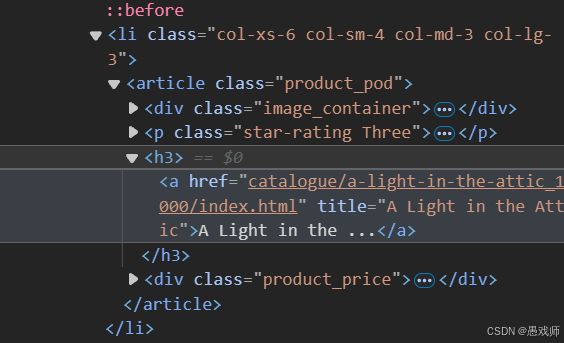
我们需要什么?书籍的图片+名字+链接,不说废话直接开始:
import requests as rq
from bs4 import BeautifulSoup as bs
from urllib.parse import urljoin
import pandas as pd

# 1.获取网页内容
url = 'http://books.toscrape.com/'
response = rq.get(url)
response.encoding = 'utf-8'
html=response.text

#2.解析网页内容
soup=bs(html,'lxml')

#3.定位到书籍位置
div_books=soup.find_all("li", class_="col-xs-6 col-sm-4 col-md-3 col-lg-3")
# print(div_books)
#4.分别获取书籍的信息
books=[]
if div_books:
    for book in div_books:
        #书籍图片
        book_img_url=book.find("img").get("src")
        full_img_url = urljoin(url, book_img_url).replace("../../", "")
        #    print(full_img_url)
        #书籍链接
        book_href=book.find("a").get('href')
        full_url=urljoin(url, book_href)
        #    print(full_url)
        #书籍名称
        book_name=book.find("h3").text.strip()
        #    print(book_name)
            #书籍价格
        book_price=book.find("p", class_="price_color").text
        #    print(book_price)
        #整合书籍数据
        books.append({
            "书籍封面":full_img_url,
            "书籍名称":book_name,
            "书籍链接":full_url,
            "书籍价格":book_price
        })
else:
    print("没有找到书籍")

#5.把书籍信息保存到excel文件中
# 转换数据为DataFrame
df = pd.DataFrame(books)[["书籍名称", "书籍价格", "书籍链接", "书籍封面"]]
try:
    # 确保已安装openpyxl: pip install openpyxl
    df.to_excel("书籍列表.xlsx",
                index=False,
                engine="openpyxl")

    print(f"成功保存 {len(df)} 条数据到 书籍列表.xlsx")
except Exception as e:
    print(f"Excel保存失败: {str(e)}")
    # 降级保存为CSV(当个保险)
    df.to_csv("书籍列表_备份.csv",
             index=False,
             encoding="utf-8-sig")
相信有了之前爬取HTML的经验,这段代码理解起来应该比较简单,唯一的难点可能是pandas库不理解。
代码解析
数据结构:字典+列表 [{}]就像是把每一本书的信息打包放在书架上
pandas库(通识版,主要是感性认知)
1. DataFrame = 快递清单表(简单理解:把数据变成表格)
import pandas as pd

# 包裹清单示例(类似Excel表格)
data = {
    "快递公司": ["顺丰", "中通", "圆通", "韵达"],
    "重量(kg)": [2.5, 1.8, 3.0, None],  # None 表示缺失信息
    "目的地": ["北京", "上海", "广州", "深圳"]
}

df = pd.DataFrame(data)
print(df)
快递公司 重量(kg) 目的地 0 顺丰 2.5 北京 1 中通 1.8 上海 2 圆通 3.0 广州 3 韵达 NaN 深圳
# 转换数据为DataFrame
df = pd.DataFrame(books)[["书籍名称", "书籍价格", "书籍链接", "书籍封面"]]
一步一步来理解:
-
创建空表格
pd.DataFrame(books) # 把杂乱的书堆整理成表格- 类比:把散落在地的快递包裹放进标准纸箱,每个箱子贴好标签(列名)
-
调整列顺序
[["书籍名称", "书籍价格", "书籍链接", "书籍封面"]] # 指定列顺序,首行(表头)- 类比:按「收件人-重量-地址-包裹类型」的顺序重新排列快递单信息
定位为什么是books = soup.find_all("li", class_="col-xs-6 col-sm-4 col-md-3 col-lg-3")而不是div_books=soup.find_all('article',class_='product_pod')
1. 代码结构定位核心差异
<!-- 图片中的实际HTML结构 -->
<li class="col-xs-6 col-sm-4 col-md-3 col-lg-3"> <!-- 商品容器 -->
    <article class="product_pod"> <!-- 商品内容区块 -->
        <div class="image_container">...</div>
        <h3>书名</h3>
        <p class="price">£20.00</p>
    </article>
</li>2. 选择<li>而非<article>的五大原因
| 对比维度 | <li class="col-*">方案 | <article class="product_pod">方案 | 图片验证结论 |
|---|---|---|---|
| 定位精准度 | ✅ 100%匹配商品容器(图片中每个商品都是<li>) | ❌ product_pod可能嵌套在非商品区块(如推荐位) | 图中展示<li>是唯一父容器 |
| 数据完整性 | ✅ 获取整个商品单元(含图片+标题+价格+按钮) | ❌ 可能遗漏外层容器中的附加数据(如库存状态) | 图中按钮在<li>范围内 |
| 布局稳定性 | ✅ Bootstrap栅格类名col-*几乎不会修改 | ❌ product_pod类名可能随UI改版变化 | 类名含响应式布局标记 |
| XPath健壮性 | ✅ 路径soup.find_all("li", class_=col-*)更稳定 | ❌ 若网站新增其他<article>内容会干扰 | 无其他col-*干扰项 |
| 多层级数据抓取 | ✅ 直接从父容器获取子元素更可靠 | ❌ 需要逐层回溯查找父级容器 | 图中数据都在<li>内 |
3. 图片验证的关键证据
-
HTML结构验证
图片显示清晰的嵌套关系:<li class="col-xs-6..."> ← 商品容器 <article class="product_pod"> ← 内容区块 [图片][标题][价格] </article> </li> -
类名功能验证
col-xs-6:移动端显示2列(12栅格/6=2列)col-md-3:桌面端显示4列(12栅格/3=4列)
这些类名明确标识商品容器的布局层级,不会用于其他元素。
-
数据分布验证
图片中的"Add to basket"按钮、星级评分等元素都在<li>内部,但不在<article>里,若用product_pod定位会丢失这些数据。
4. 错误方案的风险演示
# 错误方法:直接定位<article>
div_books = soup.find_all('article', class_='product_pod')

for book in div_books:
    # 可能漏掉的数据:
    # - 父级<li>中的库存状态 <p class="instock">
    # - 购物车按钮 <button class="btn-add">

    # 需要额外代码回溯父级:
    li_parent = book.find_parent("li")
stock_info = li_parent.find("p", class_="instock") # 增加复杂度选择<li class="col-*">的核心优势:
- 精准锁定商品容器边界(如图片中的完整商品卡片)
- 避免后续数据提取时的层级回溯
- 最大化兼容未来网站改版(布局类名通常比内容类名稳定)
这就像通过快递单号(唯一标识)而非包裹颜色(可能重复)来追踪包裹,确保抓取结果的准确性和完整性。
看看结果:
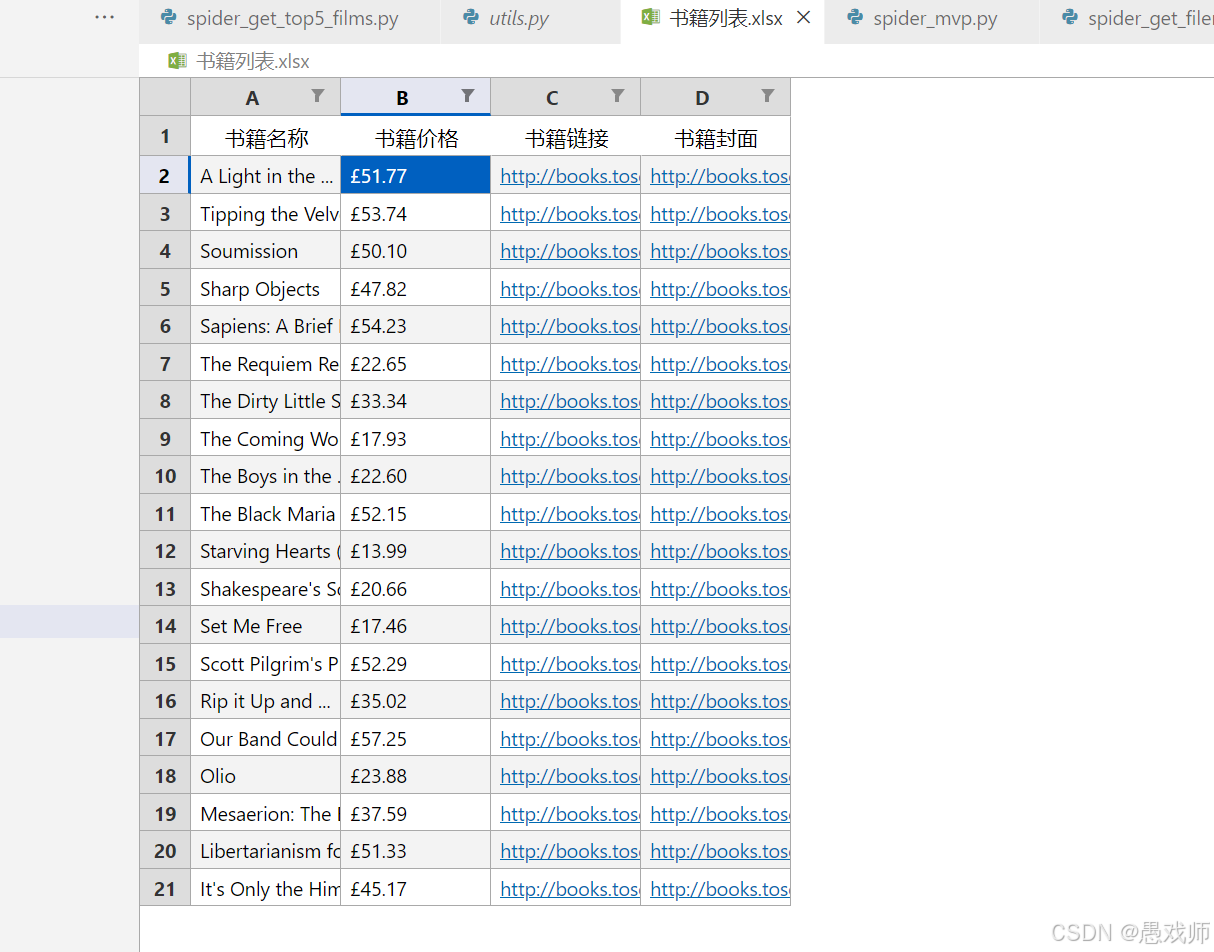
很不错呢,这看起来很舒适对吧,但是它不够优雅,这里先留个悬念,之后再继续优化,再见喽各位。
本篇完整代码:PythonFromZeroToOne/爬虫/spider_get_books.py at main · lnbhy/PythonFromZeroToOne · GitHub

助力广东及东莞地区开发者,代码托管、在线学习与竞赛、技术交流与分享、资源共享、职业发展,成为松山湖开发者首选的工作与学习平台
更多推荐
 56
 0
- 0


 已为社区贡献2条内容

所有评论(0)