登录社区云,与社区用户共同成长
邀请您加入社区
ES 中每个索引段(segment)会为字段的唯一词条生成本地序数(term → 整数 ID),但聚合 / 排序需要跨段统一映射,因此 ES 会生成全局序数它是一个「全分片唯一的词条→整数 ID」映射表,基于doc_values(keyword 默认开启)构建;作用:让聚合 / 排序直接用整数 ID 运算,大幅提升性能(避免重复解析字符串);支持字段:仅keyword(默认支持)、开启fieldd
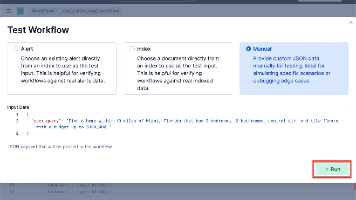
摘要:本文介绍了三种实现智能房产搜索的方法:1) 使用Python编程结合LLM调用;2) 创建定制MCP服务器;3) 无需编程的AI Agent方案。重点展示了通过Workflow创建AI Agent的完整流程,包括参数提取、地理编码、ES|QL查询构建等步骤,成功实现了自然语言查询转换为结构化搜索条件的功能。测试案例验证了该方案能有效处理"迈阿密10英里内2卧2卫、中央空调、瓷砖地板
完成本教程后,你将能够:✅ 注册并验证 Google Search Console ✅ 正确提交 sitemap.xml 到 Google ✅ 处理常见的 sitemap 错误(如循环引用) ✅ 集成 Vercel Analytics 追踪访问数据✅ 监控索引覆盖率和搜索排名✅ 解读搜索表现报告优化 SEO 策略最终成果: 网站被 Google 快速收录,并能实时查看访问数据和搜索排名!
AI 功能 (DuckAssist):2025-2026年间,它也推出了名为 “DuckAssist” 的 AI 摘要功能,可以在搜索结果顶部生成简要答案,但依然坚持隐私优先,不保存对话历史。Tavily 不是一个给人类直接打开网页去搜东西的网站,它是一个API 服务,专门设计用来让 大型语言模型(LLM) 和 AI 代理(AI Agents) 能够实时获取准确的网络信息。智能过滤与聚合:它不仅仅
我们多个项目中用到Elasticsearch,今天聚焦ES的核心知识点、高频实操技巧,尤其是深度分页这类易踩坑点,帮助大家快速上手、高效使用ES,后续也能一起交流深化。在正式讲解实操前,先快速梳理ES的常用业务场景——结合我们日常开发经验,ES并非万能,但在以下4个场景中,能大幅提升效率、解决传统数据库无法解决的痛点,也是我们部门后续可能重点用到的方向:日志检索:项目日志海量存储,快速检索异常日志
摘要:本文探讨了在混合企业环境中实现端到端可观测性的解决方案。通过结合IBM Z Observability Connect和Elastic Observability,可以解决现代云原生应用与IBM主机系统交互时的可观测性挑战。OpenTelemetry作为标准,将主机系统纳入统一监控,消除"断裂的Trace"问题。文章详细介绍了架构实现,包括Collector、Proces
本文通过实战案例演示 Elasticsearch 审计日志分析,主要内容包括:(1)创建测试索引并写入样例数据;(2)审计日志查询方法,包括按时间倒序查询和按事件类型聚合统计;(3)重点分析 SSL 异常、合规性操作等关键事件类型及其安全含义;(4)提供特定事件类型查询和时间范围过滤的 DSL 示例。分析发现 SSL 异常事件数量异常偏高,同时合规性操作日志记录完整,建议优先调查 SSL 问题并检
本文介绍了Elasticsearch ES|QL中新增的向量搜索功能,包括对dense_vector字段的原生支持以及KNN函数和向量相似度函数的使用。通过创建包含3维向量的产品索引示例,演示了如何执行近似最近邻搜索(KNN)和精确搜索(向量相似度函数),并展示了如何结合传统过滤条件进行高效查询。文章还介绍了可选参数微调、TEXT_EMBEDDING函数等高级功能,强调ES|QL为语义搜索提供了灵
本文介绍了使用Elasticsearch和Kibana构建国家/地区指标对比地图的教程。通过ES|QL新增函数LOOKUPJOIN和ST_GEOTILE,演示了创建choropleth图层(按网络流量着色)、添加文档点图层(显示单个日志)和聚合数据图层(显示网格化统计)的步骤。特别展示了如何通过人口数据对流量指标进行标准化处理,使国家间的比较更加公平。教程详细说明了从上传地理数据、创建索引到构建地
文章摘要:Elasticsearch与Microsoft Azure AI Foundry Agent Service的深度整合解决了企业级AI应用的核心挑战——如何确保智能代理基于专有数据生成可信响应。该集成通过两种协议实现:1)MCP协议让Elasticsearch作为知识库提供数据支撑;2)A2A协议支持不同代理间的协作工作流。这种技术架构既保证了响应准确性,又实现了复杂任务编排,使企业能够
注意:这里我们引入了cppjieba库,安装包需要自己去gitee去搜索这里就不提供了这个cppjieba库我们只用了下面两个文件一个是dict,一个是cppjieba,这里我们用了软连接将其链接在了本目录下,专门用了threadpart目录来保存本项目使用的各种库。
我们知道在 DSL 中我们可以轻松地使用 RRF 及线性来针对多路搜索进行混合搜索。请详细阅读之前的文章 “在上面,我们使用了 RRF。有关 RRF 的介绍,请阅读文章 “我们也可以使用线性组合来平衡混合搜索。请详细阅读文章 “随着 ES|QL 的推出,越来越多的查询会使用 ES|QL 来做查询,那么我们该如何实现混合搜索呢?Elastic 在 9.1 中开始推出 FORK 及 FUSE 命令来帮
本文介绍了如何在Azure Kubernetes Service(AKS) Automatic上使用Elastic Cloud on Kubernetes(ECK)部署Elasticsearch和Kibana。通过AKS Automatic可自动管理集群资源,降低运维复杂度。教程详细说明了从创建AKS Automatic集群到安装ECK operator、部署Elasticsearch单节点和配置
elasticsearch.hosts: ["http://192.168.158.6:9200","http://192.168.166.113:9200","http://192.168.166.114:9200"] #连接的elasticsearch服务器。discovery.zen.ping.unicast.hosts: ["192.168.158.6", "192.168.166.113
本文对比了Elasticsearch中query与filter的本质差异及适用场景。核心观点包括:1)query用于计算相关性评分(_score),适合关键词搜索;2)filter通过bitset缓存实现高效筛选,适合精确匹配;3)filter不计算_score,性能优于query。文章通过示例代码展示了Java API用法,并建议实践时混合使用两者:query处理搜索需求,filter处理筛选条
摘要:Elasticsearch团队通过实验优化AIagent工作流中的索引选择机制,发现仅依靠索引名称准确率仅77%。通过测试结合索引描述、字段名和语义搜索等方法,最终采用混合搜索筛选候选索引再交由LLM决策的方案,将准确率提升至90%以上。该研究证实了数据驱动决策的价值,并揭示了可搜索索引元数据的重要性,为构建更智能的Agent工具奠定了基础。
《搜索百科》专栏首篇详解Apache Lucene:搜索技术的基石 Lucene是由Doug Cutting于1997年开发的Java全文搜索引擎库,1999年首次发布,2001年加入Apache基金会。作为底层搜索库,它提供了强大的索引查询、分词、相关性评分等功能,是Elasticsearch、Solr等现代搜索引擎的核心引擎。 25年来,Lucene凭借高性能检索、可扩展分析链和稳定版本线保持
Elastic官方发布了elastic-esql gem工具,帮助开发者用Ruby代码构建Elasticsearch的ES|QL查询。该工具采用链式调用方式,支持常见查询操作(如LIMIT、SORT等),并能转换为标准ES|QL语句。既可与Elasticsearch Ruby客户端配合使用,也可作为独立工具使用。目前以技术预览版发布,支持自定义查询字符串,开发者可通过Gemfile安装gem 'e
情况结果建议不做任何处理糟糕:内容重复,权重分散,排名受损。必须避免正确设置301重定向优秀:所有权重集中到首选域名,无重复内容问题。必须执行仅在Search Console设置不够:这只能提示谷歌,但无法解决其他搜索引擎和浏览器直接访问的问题。必须配合301重定向。需与重定向配合搜索引擎收录带www和不带www的版本有本质区别。您必须通过301永久重定向技术手段,将其中一个版本定向到您选择的首选
ElasticSearch是一个开源的分布式搜索引擎,广泛应用于搜索、日志分析、监控等领域。它与MySQL等传统数据库不同,采用倒排索引机制实现高效搜索。ElasticSearch是ELK技术栈的核心组件,常与Logstash、Kibana等工具配合使用。
本文介绍ES的删除策略:逻辑删除。
优先采用Declarative Shadow DOM:确保服务器端渲染兼容性,减少客户端性能损耗。显式暴露结构化数据:将Shadow DOM中的Schema标记移至主文档或动态注入。结合SSR框架优化性能:通过Next.js/Nuxt.js实现首次加载时的完整HTML输出。监控Core Web Vitals:定期使用Lighthouse或PageSpeed Insights检测核心性能指标。通过以
Yandex 是俄罗斯领先的互联网公司,其搜索引擎在俄罗斯及东欧地区占据主导地位,市场份额曾超过 60%,被广泛称为“俄罗斯的谷歌”。它不仅提供搜索服务,还包括电子邮件、云存储、翻译、地图和打车服务等,特别适合本地用户和跨境电商需求。Yandex 是俄罗斯互联网领域的龙头企业,其搜索引擎在俄罗斯及东欧地区占据主导地位,市场份额曾超过 60%,提供多样化的服务如搜索、邮件、云存储和地图。2024 年
本文介绍了如何在本地部署阿里Qwen3大模型并连接到Elasticsearch实现RAG应用。主要内容包括: 创建Elasticsearch API key获取访问凭证 编写Python代码实现RAG流程,包括Elasticsearch查询、上下文构建和Qwen3模型调用 配置环境变量和证书,确保代码正常运行 测试Qwen3模型接口工作正常 修改代码适配最新Elasticsearch版本的数据结构
2025 年 1 月,腾讯云 ES 团队上线了 Elasticsearch 8.16.1 AI 搜索增强版,此发布版本重点提升了向量搜索、混合搜索的能力,为 RAG 类的 AI Search 场景保驾护航。除了紧跟 ES 官方在向量搜索上的大幅优化动作外,腾讯云 ES 还在此版本上默认内置了一个全新的插件 —— v-pack 插件。v-pack 名字里的 "v" 是 vector 的意思,旨在提
一个完整的日志收集方案:Elasticsearch + Logstash + Kibana+Filebeat
rag整体流程优化
本文详细介绍了如何安装并配置MCPServer来连接Elasticsearch数据库,实现通过自然语言对话查询数据。主要内容包括:1)安装Elasticsearch和Kibana;2)获取Elasticsearch API密钥;3)下载并配置MCP服务器;4)使用Claude Desktop应用连接MCP服务器;5)通过实例演示了索引查询、数据统计等操作。该方法实现了智能代理与Elasticsea
《中国人工智能智能体研究报告》概述了人工智能智能体在中国的兴起、发展现状及未来趋势。报告首先定义了人工智能智能体,强调其自主性和处理复杂任务的能力,并指出大型语言模型(LLMs)技术的进步是推动其发展的关键因素。中国在该领域呈现出多元化发展态势,包括百度、阿里巴巴、科大讯飞等科技巨头以及众多初创企业积极参与,市场潜力巨大。 报告详细分析了中国主要的人工智能智能体平台,如百度千帆AgentBuild
本文由Elastic的Kofi Bartlett撰写,主要探讨了在Elasticsearch中删除文档字段的三种方法。首先,使用Update API可以直接从特定文档中移除字段,适用于个别文档的字段删除需求。其次,通过Reindex API创建一个新索引,并在复制过程中移除指定字段,适用于需要从所有文档中删除字段的场景。最后,更新映射并重新索引的方法适用于需要同时从映射和所有文档中删除字段的情况。
解释如何使用和来连接 Elasticsearch 中的两个索引。Elasticsearch 拥有丰富的新功能,帮助你为自己的使用场景构建最佳搜索解决方案。深入阅读我们的,了解更多信息,开始,或立即在上尝试 Elastic。在 Elasticsearch 中,连接两个索引不像传统 SQL 数据库那样直接。然而,可以通过 Elasticsearch 提供的一些技术和功能实现类似的效果。本文将深入介绍在
移动端可微信小程序搜索“”)总架构师,15年工作经验,精通Java编程高并发设计,熟悉LinuxESXI虚拟化以及,热衷于探索科技的边界,并将理论知识转化为实际应用。保持对新技术的好奇心,乐于分享所学,希望通过我的实践经历和见解,启发他人的创新思维。在这里,我希望能与志同道合的朋友交流探讨,共同进步,一起在技术的世界里不断学习成长。请加本人wx(注明来自csdn。
在这篇博客中,我们将向你展示如何配置和自定义 LangGraph Retrieval Agent 模板与 Elasticsearch,以构建一个强大的 RAG 工作流,实现高效的数据检索和由 AI 驱动的响应。本博客重点介绍如何使用 LangGraph Studio 和 LangGraph CLI 运行并自定义 LangChain Retrieval Agent Template。该模板为构建检索
探索 Elasticsearch 堆内存使用情况和 JVM 垃圾回收,包括最佳实践以及在堆内存使用过高或 JVM 性能不佳时的解决方法。堆内存大小是分配给 Elasticsearch 节点中 Java 虚拟机的 RAM 数量。从 7.11 版本开始,Elasticsearch 默认会根据节点的角色和总内存自动设置 JVM 堆内存大小。对于大多数生产环境,推荐使用默认配置。然而,如果你希望手动设置
不可否认的是:生成式 AI(- GenAI)正在重塑 IT 的未来(甚至可能是世界的未来)。根据 Forrester 2024 年的脉搏调查,67% 的 AI 决策者表示,他们的组织计划在未来一年增加对生成式 AI 的投资。那么,什么只是生成式 AI 的炒作,什么又值得长期投资呢?IT 和商业领导者如何区分事实与虚构?这种热潮带来了兴奋和怀疑。人们对生成式 AI 如何收集数据、其安全措施以及其对
将多值字段转换为字符串通配符模式匹配使用全文本功能,将更新 _score 元数据字段条件加权加权最近内容组合评分基于自定义评分进行过滤。
今天,我们很高兴地宣布 Elastic 9.0 和 8.18 的正式发布!Elastic 9.0 基于 Lucene 10.0,标志着 Elasticsearch、Elastic 搜索 AI 平台以及其核心解决方案 Elastic Observability 和 Elastic Security 的一次重大升级。此版本带来了更快的性能和更高的效率,得益于 Lucene 10.0 的内置改进,如更
向量搜索是当前的热门话题,但大多数讨论集中在密集向量上:用于机器学习和神经搜索的紧凑型数值表示。而稀疏向量则采用了不同的路径。与紧密压缩数据的密集向量不同,稀疏向量以更具可解释性和结构化的格式存储信息,通常包含大量的零。虽然没有那么受关注,但在合适的场景下,它们的能力是非常强大的。💡 趣味小知识:稀疏向量和倒排索引都利用稀疏性来高效地表示和检索信息。在 Elasticsearch 中,你可以使用
AI 会开始取代网络安全工作吗?不会,但它正在从根本上改变这些工作。正迅速成为日常安全工作流程中的一个重要组成部分。那么,它是合作伙伴还是竞争对手?GenAI 技术在安全堆栈几乎每个方面的广泛应用,整体上帮助安全团队更高效地应对威胁。GenAI 使安全从业者能够访问并分析他们原本无法获得的数据,从而使他们的工作比以往任何时候都更具影响力。然而,与此同时,GenAI 也扩展了攻击面 —— 无论是通过
在传统数据库中,模糊查询往往难以应对现实中的复杂情况。随着数据量的增加,查询时间显著变慢,功能也相对单一。当搜索时出现错别字或拼音输入时,搜索结果往往不尽如人意。因此,我们需要学习一种强大的搜索框架技术——ElasticSearch。
Elasticsearch AI Assistant 是基于生成式人工智能(GenAI)和大型语言模型(LLM)技术构建的智能运维解决方案。该产品深度融合 Elasticsearch 底层能力,通过自然语言交互与上下文感知两大核心特性,为可观测性分析、安全运维管理及数据智能处理提供一站式解决方案。深度集成:直接调用 Elasticsearch API 实现集群实时状态诊断,支持动态生成可视化数据看