登录社区云,与社区用户共同成长
邀请您加入社区
Kimi 团队发布 Attention Residuals 论文,用 softmax 注意力替代传统均等残差连接,在深度方向实现选择性信息聚合,在 48B MoE 模型上实现 1.25x 计算效率提升,推理延迟增加不到 2%。
Fun-Audio-Chat 是一款专注于自然、低延迟语音交互的大型音频语言模型。它通过引入双分辨率语音表征(5Hz 的高效共享主干 + 25Hz 的精细头部)大幅降低计算成本,同时保持高质量语音输出,并采用 Core-Cocktail 训练策略保留强大的文本语言模型能力。该模型在口语问答、音频理解、语音功能调用、语音指令跟随和语音共情等多个基准测试中均取得了顶尖成绩。
深度学习是机器学习的一种特殊方法,而机器学习是实现人工智能的主要途径。
AI 功能 (DuckAssist):2025-2026年间,它也推出了名为 “DuckAssist” 的 AI 摘要功能,可以在搜索结果顶部生成简要答案,但依然坚持隐私优先,不保存对话历史。Tavily 不是一个给人类直接打开网页去搜东西的网站,它是一个API 服务,专门设计用来让 大型语言模型(LLM) 和 AI 代理(AI Agents) 能够实时获取准确的网络信息。智能过滤与聚合:它不仅仅
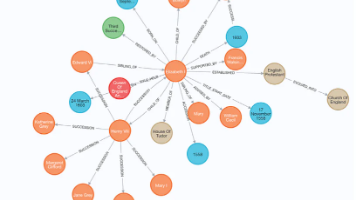
本项目是一个基于知识图谱的乳制品生产智能问答系统,采用Vue3+Flask+Neo4j技术栈实现。系统包含用户端和管理端两大模块,支持文档管理、智能问答、知识图谱构建与可视化、产品生产记录管理等功能。创新性地采用GraphRAG三路并行检索技术,结合16种实体类型和20种关系类型的知识图谱,实现精准问答。系统支持多模态输入,提供完整的用户管理、会话记录和可视化分析功能,为乳制品生产企业提供智能化知
本文介绍了基于LangChain和HuggingFace的本地大语言模型部署方案,以Qwen1.5-0.5B-Chat为例。重点包括:1)环境配置与模型加载,支持GPU/CPU自动分配;2)构建文本生成Pipeline,详细解析温度值、top_k等关键参数;3)LangChain集成实现多轮对话管理;4)性能优化策略如混合精度推理和量化技术。该方案具有数据安全、成本可控等优势,适用于客服系统、教育
本文介绍了一个完全离线的翻译小程序开发方案,针对在线翻译工具存在的网络依赖、隐私泄露等痛点,提出了基于本地大语言模型(LLM)的解决方案。系统架构包括用户界面、翻译控制器、本地LLM模型和后处理模块,支持多语言翻译且不依赖网络连接。推荐使用LLaMA3、Mistral等4-8GB量化的多语言模型,并提供完整的Python实现代码,包含模型加载、翻译提示构造和结果处理等功能。文章还探讨了GUI界面开
Transformer 大语言模型(LLM)基石 - Transformer架构详解 - 位置编码(Positional Encoding)详解与算法实现
本文摘要介绍了文本预处理和语言模型的基础知识,以及RNN、GRU、LSTM等神经网络模型。主要内容包括:1)文本预处理步骤(读取数据、词元化、构建词表);2)语言模型定义与实现(n元语法模型、困惑度评估);3)RNN及其变体GRU、LSTM的原理;4)编码器-解码器架构及其在seq2seq任务中的应用。重点强调了文本预处理和语言模型的重要性,而RNN系列模型仅需了解。文中提供了完整的代码实现,包括
部署极简 高并发/多卡能力依赖后端引擎;动态批处理、并发、多 GPU;Xinference 多模型网关 企业私有化、统一治理、异构引擎 Linux/容器、CPU/GPU 统一管理 LLM/Embedding/Rerank;Ollama 本地运行器 个人/开发者的本地体验、快速原型、小型服务 Win/macOS/Linux、CPU/GPU 安装与命令行极简;llama.cpp 推理引擎 资源受限设备
25年10月来自加拿大UBC、加拿大 Alberta大学、小米电动汽车和加拿大东北大学的论文 “NanoVLA: Routing Decoupled Vision-Language Understanding For Nano-Sized Generalist Robotic Policies ”。视觉-语言-动作 (VLA) 模型通过将视觉-语言模型 (VLM) 和动作解码器集成到统一的架构中,
GPT、DeepSeek等大语言模型应用
本文介绍了注意力机制的几种变体及其PyTorch代码实现。主要包括: Self-Attention:基础自注意力机制,通过Q、K、V计算注意力权重,适用于序列内部建模。 CrossAttention:让一个序列关注另一个序列,典型应用于Transformer解码器-编码器交互和多模态任务。 CausalAttention:通过三角掩码实现因果性,确保只能关注当前位置之前的token,适用于自回归生
本文介绍了使用LLaMA-Factory框架微调大模型的详细流程。首先准备虚拟环境并安装LLaMA-Factory及相关依赖,然后下载基座模型和训练数据集。文章提供了两种微调方式:通过Web页面可视化操作或命令行执行。最后演示了如何测试微调后的模型,包括Web界面和命令行两种方式。整个过程涵盖环境搭建、数据准备、参数配置到模型推理的全流程,相比Unsloth框架更简单易用。
实际上,在今年 1 月发布时(早于 Llama 4、Gemma 3 和 Qwen 3),OLMo 2 系列模型正处于计算效率与性能的帕累托前沿【译者注:“帕累托前沿”(Pareto Frontier)是一个起源于经济学和优化理论的重要概念,它描述的是一种最优状态,在这种状态下,任何一方的利益或某个目标的提升都无法不以牺牲其他方利益或其他目标的下降为代价。今天我们为大家带来的这篇文章,作者的核心观点
25年8月来自的论文“Large VLM-based Vision-Language-Action Models for Robotic Manipulation: A Survey”。机器人操控是机器人技术和具身人工智能的关键前沿,需要精确的运动控制以及对动态环境中视觉和语义线索的综合理解。传统方法基于预定义的任务规范和严格的控制策略,往往难以在非结构化的新场景中扩展或推广。近年来,基于在海量图
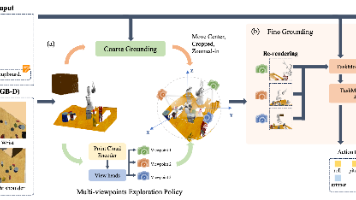
25年8月来自中山大学、鹏程实验室、新加坡 NUS 和中科院深圳技术院的论文“Learning to See and Act: Task-Aware View Planning for Robotic Manipulation”。近期用于多任务机器人操作的视觉-语言-动作 (VLA) 模型通常依赖于静态视点和共享视觉编码器,这限制了 3D 感知并导致任务干扰,从而阻碍了鲁棒性和泛化。这项工作提出任
Graph RAG:知识图谱增强的智能搜索新范式 摘要:Graph RAG(检索增强生成)通过整合知识图谱和大型语言模型(LLM),为传统搜索技术带来革命性突破。相比基于向量检索的原始RAG方法,Graph RAG利用结构化知识图谱中的节点(实体)和边(关系),显著提升了搜索的上下文理解能力、推理深度和领域适应性。本文系统阐述了Graph RAG的技术原理,包括知识图谱构建、图嵌入表示、LLM集成
Dify实验室阿亚团队探索了利用大模型进行数据分析的优化路径。初期尝试直接使用大模型处理数据时发现计算结果存在偏差,揭示了语言模型在精确计算上的局限性。第二阶段转向专用分析模型,但面临灵活性不足的问题。最终突破在于让大模型担任"代码生成器",将自然语言转化为Pandas代码,在本地执行环境中完成精确计算。这种协同架构既保留了自然语言交互的便捷性,又确保了计算准确性,同时保障了数