科普文:算法和数据结构系列【数据结构:链表扩展之有序链表(Sorted Linked List)和LRU缓存链表(LRU Cache Linked List)原理、应用即java实现】
概叙
科普文:算法和数据结构系列【算法和数据结构概叙】-CSDN博客
科普文:算法和数据结构系列【数据结构:数组和链表】-CSDN博客
科普文:算法和数据结构系列【数据结构:链表扩展之跳表Skip List原理、应用即java实现跳表】-CSDN博客
双向链表 (Doubly Linked List)
双向链表是一种链表数据结构,其中每个节点包含数据、指向前一个节点的指针(prev)和指向下一个节点的指针(next)。这使得节点可以从两个方向遍历,让双向链表可以从任意方向遍历链表。
原理
双向链表允许从任意节点开始向前或向后遍历链表。插入和删除操作需要修改相邻节点的指针,但通常可以在常数时间内完成。
在双向链表中,插入新元素时,需要根据元素的值找到合适的位置,以确保链表的有序性。这通常涉及到遍历链表,找到合适的位置来插入新节点。
优缺点
优点:插入和删除操作相对较快,因为不需要移动大量元素;可以快速访问最小(或最大)值。
- 插入和删除操作高效,特别是在已知节点位置的情况下。
- 双向遍历能力提供了灵活性,适用于需要双向访问的场景。
缺点:访问效率低,需要从头节点开始遍历。
- 相对于单向链表,每个节点需要额外的指针存储空间。
- 链表本身不是随机访问的,访问特定元素可能需要O(n)的时间复杂度。
应用场景
优先队列、索引结构、缓存(如LRU缓存)、排序算法(如归并排序)、统计数据(如计算中位数、百分位数)。
- 需要在链表两端频繁进行插入和删除操作的数据结构。
- 双向遍历需求,如撤销/重做功能、双向队列等。
注意事项
插入和删除操作的时间复杂度为O(n),在链表中间插入或删除时。需要额外的空间来维护元素的顺序。
- 插入和删除操作需要维护前后指针的正确性。
- 遍历链表时,要注意边界条件,如空链表或只有一个节点的链表。
java实现双向链表
// 创建一个双向链表的类
class DoubleLinkedList {

	// 先初始化一个头节点, 头节点不要动, 不存放具体的数据
	private HeroNode2 head = new HeroNode2(0, "", "");

	// 返回头节点
	public HeroNode2 getHead() {
		return head;
	}

	// 遍历双向链表的方法
	// 显示链表[遍历]
	public void list() {
		// 判断链表是否为空
		if (head.next == null) {
			System.out.println("链表为空");
			return;
		}
		// 因为头节点,不能动,因此我们需要一个辅助变量来遍历
		HeroNode2 temp = head.next;
		while (true) {
			// 判断是否到链表最后
			if (temp == null) {
				break;
			}
			// 输出节点的信息
			System.out.println(temp);
			// 将temp后移, 一定小心
			temp = temp.next;
		}
	}

	// 添加一个节点到双向链表的最后.
	public void add(HeroNode2 heroNode) {

		// 因为head节点不能动,因此我们需要一个辅助遍历 temp
		HeroNode2 temp = head;
		// 遍历链表,找到最后
		while (true) {
			// 找到链表的最后
			if (temp.next == null) {//
				break;
			}
			// 如果没有找到最后, 将将temp后移
			temp = temp.next;
		}
		// 当退出while循环时,temp就指向了链表的最后
		// 形成一个双向链表
		temp.next = heroNode;
		heroNode.pre = temp;
	}

	// 修改一个节点的内容, 可以看到双向链表的节点内容修改和单向链表一样
	// 只是 节点类型改成 HeroNode2
	public void update(HeroNode2 newHeroNode) {
		// 判断是否空
		if (head.next == null) {
			System.out.println("链表为空~");
			return;
		}
		// 找到需要修改的节点, 根据no编号
		// 定义一个辅助变量
		HeroNode2 temp = head.next;
		boolean flag = false; // 表示是否找到该节点
		while (true) {
			if (temp == null) {
				break; // 已经遍历完链表
			}
			if (temp.no == newHeroNode.no) {
				// 找到
				flag = true;
				break;
			}
			temp = temp.next;
		}
		// 根据flag 判断是否找到要修改的节点
		if (flag) {
			temp.name = newHeroNode.name;
			temp.nickname = newHeroNode.nickname;
		} else { // 没有找到
			System.out.printf("没有找到 编号 %d 的节点,不能修改\n", newHeroNode.no);
		}
	}

	// 从双向链表中删除一个节点,
	// 说明
	// 1 对于双向链表,我们可以直接找到要删除的这个节点
	// 2 找到后,自我删除即可
	public void del(int no) {

		// 判断当前链表是否为空
		if (head.next == null) {// 空链表
			System.out.println("链表为空,无法删除");
			return;
		}

		HeroNode2 temp = head.next; // 辅助变量(指针)
		boolean flag = false; // 标志是否找到待删除节点的
		while (true) {
			if (temp == null) { // 已经到链表的最后
				break;
			}
			if (temp.no == no) {
				// 找到的待删除节点的前一个节点temp
				flag = true;
				break;
			}
			temp = temp.next; // temp后移,遍历
		}
		// 判断flag
		if (flag) { // 找到
			// 可以删除
			// temp.next = temp.next.next;[单向链表]
			temp.pre.next = temp.next;
			// 这里我们的代码有问题?
			// 如果是最后一个节点,就不需要执行下面这句话,否则出现空指针
			if (temp.next != null) {
				temp.next.pre = temp.pre;
			}
		} else {
			System.out.printf("要删除的 %d 节点不存在\n", no);
		}
	}

}

// 定义HeroNode2 , 每个HeroNode 对象就是一个节点
class HeroNode2 {
	public int no;
	public String name;
	public String nickname;
	public HeroNode2 next; // 指向下一个节点, 默认为null
	public HeroNode2 pre; // 指向前一个节点, 默认为null
	// 构造器

	public HeroNode2(int no, String name, String nickname) {
		this.no = no;
		this.name = name;
		this.nickname = nickname;
	}

	// 为了显示方法,我们重新toString
	@Override
	public String toString() {
		return "HeroNode [no=" + no + ", name=" + name + ", nickname=" + nickname + "]";
	}

}
运行结果: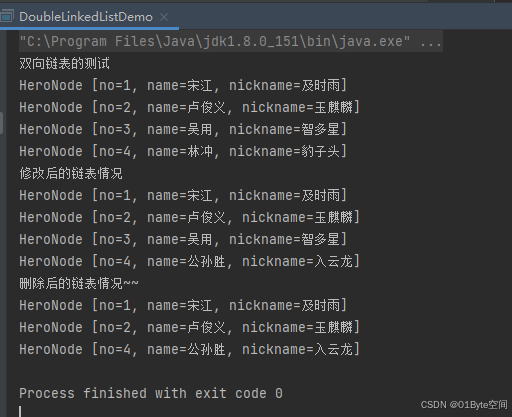
有序链表 (Sorted Linked List)
有序链表是一种链表数据结构,其中节点按照某种顺序(如升序或降序)排列。
有序链表是一种链表,其中元素按照特定的顺序(通常是升序或降序)排列。这种特性使得有序链表在某些应用中非常有用,例如在需要频繁插入与搜索的场景。
原理
插入新节点时,需要遍历链表以找到正确的插入位置,以保持链表的有序性。查找操作也可以利用链表的有序性来优化。
在有序链表中,插入新元素时,需要根据元素的值找到合适的位置,以确保链表的有序性。这通常涉及到遍历链表,找到合适的位置来插入新节点。
优缺点
优点:插入和删除操作相对较快,因为不需要移动大量元素;可以快速访问最小(或最大)值。
- 插入和删除操作虽然需要遍历链表,但链表本身可以动态增长,无需预分配空间。
- 查找操作(如果实现得当)可以利用有序性进行二分查找或类似优化,提高性能。
缺点:访问效率低,需要从头节点开始遍历。
- 插入和删除操作通常需要O(n)的时间复杂度。
- 访问特定元素仍然需要O(n)的时间复杂度,除非实现额外的索引结构。
应用场景
- 需要保持元素有序且频繁进行插入和删除操作的数据结构。
- 优先级队列等需要有序访问的场景。
- 优先队列
- 索引结构
- 缓存(如LRU缓存)
- 排序算法(如归并排序)
- 统计数据(如计算中位数、百分位数)
注意事项
- 插入和删除操作需要确保链表的有序性。
- 查找操作可以利用有序性进行优化,但实现复杂度可能增加。
- 插入和删除操作的时间复杂度为O(n),在链表中间插入或删除时。
- 需要额外的空间来维护元素的顺序。
java实现有序链表
package com.zxx.study.algorithm.datastruct.DataStructures.linkedlist;

/**
 * @author zhouxx
 * @create 2025-01-07 5:30
 */
// 有序链表类
public class SortedLinkedList<T extends Comparable<T>> {
    private ListNode<T> head;

    public SortedLinkedList() {
        this.head = null;
    }

    // 插入数据,保持链表有序
    public void insert(T data) {
        ListNode<T> newNode = new ListNode<>(data);
        // 插入前先比较大小:小的往前放、大的往后放。
        if (head == null || head.data.compareTo(data) >= 0) {
            newNode.next = head;
            head = newNode;
        } else {
            ListNode<T> current = head;
            while (current.next != null && current.next.data.compareTo(data) < 0) {
                current = current.next;
            }
            newNode.next = current.next;
            current.next = newNode;
        }
    }

    // 删除数据
    public boolean delete(T data) {
        if (head == null) {
            return false;
        }

        if (head.data.equals(data)) {
            head = head.next;
            return true;
        }

        ListNode<T> current = head;
        while (current.next != null && !current.next.data.equals(data)) {
            current = current.next;
        }

        if (current.next == null) {
            return false; // 数据不存在于链表中
        }

        current.next = current.next.next;
        return true;
    }

    // 查找数据
    public boolean search(T data) {
        ListNode<T> current = head;
        while (current != null) {
            if (current.data.equals(data)) {
                return true;
            }
            current = current.next;
        }
        return false;
    }

    // 打印链表
    public void printList() {
        ListNode<T> current = head;
        while (current != null) {
            System.out.print(current.data + " -> ");
            current = current.next;
        }
        System.out.println("null");
    }
    // 链表节点类
    class ListNode<T extends Comparable<T>> {
        T data;
        ListNode<T> next;

        ListNode(T data) {
            this.data = data;
            this.next = null;
        }
    }
    // 主方法,用于测试有序链表的功能
    public static void main(String[] args) {
        SortedLinkedList<Integer> sortedList = new SortedLinkedList<>();

        // 插入数据
        sortedList.insert(5);
        sortedList.insert(3);
        sortedList.insert(8);
        sortedList.insert(1);
        sortedList.insert(7);

        // 打印链表
        System.out.println("链表内容:");
        sortedList.printList();

        // 查找数据
        System.out.println("查找 3: " + sortedList.search(3));
        System.out.println("查找 10: " + sortedList.search(10));

        // 删除数据
        sortedList.delete(3);
        System.out.println("删除 3 后的链表内容:");
        sortedList.printList();

        sortedList.delete(1);
        System.out.println("删除 1 后的链表内容:");
        sortedList.printList();

        sortedList.delete(8);
        System.out.println("删除 8 后的链表内容:");
        sortedList.printList();
    }
}
运行结果: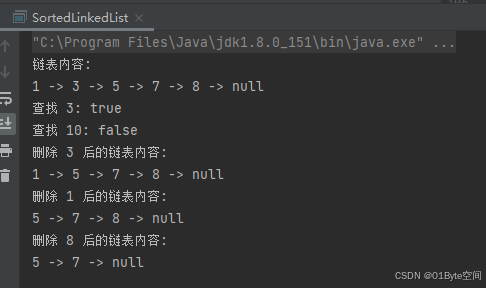
核心方法:insert,在插入数据时,先排序,再插入。默认和头节点比,小的往前放、大的往后放。
LRU链表 (Least Recently Used Linked List)
LRU链表是实现LRU缓存替换策略的一种数据结构,其中最近使用的元素被移动到链表头部,最久未使用的元素位于链表尾部。
LRU(Least Recently Used)链表是一种常用的缓存淘汰策略,它根据数据的使用顺序来管理缓存。最近使用的数据被放置在链表的头部,而最久未使用的数据则被放置在链表的尾部。
原理
LRU链表通常基于双向链表实现,结合哈希表来快速查找缓存中的数据。当缓存达到其容量上限时,最近最少使用的数据会被优先淘汰。
LRU链表通常与哈希表结合使用。哈希表用于快速查找元素,而双向链表用于维护元素的使用顺序。每次访问元素时,都将其从链表中移除并重新插入到头部。当缓存达到容量限制时,尾部元素被移除。
优缺点
优点:高效,能够快速访问最近使用的项,减少缓存未命中率。
- 高效管理缓存,提高缓存命中率。
- 双向链表和哈希表的结合使得插入、删除和查找操作都能够在常数时间内完成。
缺点:缓存大小受限,无法缓存所有数据;频繁访问的项可能被淘汰。
- 相对于其他缓存策略(如FIFO、LFU),LRU可能不是所有情况下的最优选择。
- 需要额外的空间来存储指针和哈希表条目。
应用场景
- 缓存系统,如页面缓存、数据库查询缓存等。
- 需要频繁访问最近使用数据项的应用场景。
- 操作系统中的页面置换
- 数据库查询优化
- Web缓存等
科普文:Java基础之算法系列【哈希算法和位图:手搓LRU(Least Recently Used)过滤器】-CSDN博客
注意事项
实现LRU算法需要同时维护数据的访问顺序和快速查找能力,这可能会增加实现的复杂性。
- 需要确保链表和哈希表之间的同步,以避免数据不一致。
- 当缓存达到容量限制时,要及时移除尾部元素并更新哈希表。
- LRU链表可能不适合所有访问模式,选择缓存策略时应考虑具体应用场景。
java实现LRU链表
package com.zxx.study.algorithm.datastruct.DataStructures.linkedlist;

import java.util.HashMap;

/**
 * @author zhouxx
 * @create 2025-01-07 5:46
 */
// LRU缓存类
public class LRUCache<K, V> {
    // 双向链表节点类
    class DLinkedNode<K, V> {
        K key;
        V value;
        DLinkedNode<K, V> prev;
        DLinkedNode<K, V> next;

        DLinkedNode(K key, V value) {
            this.key = key;
            this.value = value;
        }
    }
    private final int capacity;
    private final HashMap<K, DLinkedNode<K, V>> map;
    private final DLinkedNode<K, V> head;
    private final DLinkedNode<K, V> tail;

    public LRUCache(int capacity) {
        this.capacity = capacity;
        this.map = new HashMap<>(capacity);
        this.head = new DLinkedNode<>(null, null); // 哨兵头节点
        this.tail = new DLinkedNode<>(null, null); // 哨兵尾节点
        head.next = tail;
        tail.prev = head;
    }

    // 获取缓存中的值
    public V get(K key) {
        DLinkedNode<K, V> node = map.get(key);
        if (node == null) {
            return null; // 缓存中不存在该键
        }
        System.out.print("key moveToHead :"+key+",value=");
        moveToHead(node); // 将访问的节点移动到链表头部
        return node.value;
    }

    // 将键值对放入缓存中
    public void put(K key, V value) {
        DLinkedNode<K, V> node = map.get(key);
        if (node == null) {
            // 插入新节点到链表头部,并更新哈希表
            DLinkedNode<K, V> newNode = new DLinkedNode<>(key, value);
            map.put(key, newNode);
            addToHead(newNode);
            if (map.size() > capacity) {
                // 如果缓存超出容量,移除链表尾部的节点
                DLinkedNode<K, V> tail = removeTail();
                map.remove(tail.key);
            }
        } else {
            // 更新已有节点的值,并将其移动到链表头部
            node.value = value;
            moveToHead(node);
        }
    }

    // 将节点移动到链表头部
    private void moveToHead(DLinkedNode<K, V> node) {
        removeNode(node);
        addToHead(node);
    }

    // 添加节点到链表头部
    private void addToHead(DLinkedNode<K, V> node) {
        node.prev = head;
        node.next = head.next;
        head.next.prev = node;
        head.next = node;
    }

    // 从链表中移除节点
    private void removeNode(DLinkedNode<K, V> node) {
        node.prev.next = node.next;
        node.next.prev = node.prev;
    }

    // 移除并返回链表尾部的节点
    private DLinkedNode<K, V> removeTail() {
        DLinkedNode<K, V> res = tail.prev;
        removeNode(res);
        return res;
    }
    // 打印链表
    public void printList() {
        DLinkedNode<K, V> current = head;
        while (current != null) {
            System.out.print("{key="+current.key+",value="+current.value + "} <--> ");
            current = current.next;
        }
        System.out.println("null");
    }
    // 主方法,用于测试LRU缓存的功能
    public static void main(String[] args) {
        LRUCache<Integer, String> lruCache = new LRUCache<>(3);

        lruCache.put(1, "One");
        lruCache.printList();
        lruCache.put(2, "Two");
        lruCache.printList();
        lruCache.put(3, "Three");
        lruCache.printList();
        System.out.println(lruCache.get(1)); // 输出: One;此时1已经移到头部了,2是尾部。
        lruCache.printList();

        lruCache.put(4, "Four"); // 2被移除,因为缓存容量是3,并且1
        System.out.println(lruCache.get(2)); // 输出: null
        lruCache.printList();

        lruCache.put(5, "Five"); // 3被移除,因为缓存容量是3
        lruCache.printList();
        System.out.println(lruCache.get(3)); // 输出: null
        lruCache.printList();

        System.out.println(lruCache.get(4)); // 输出: Four
        System.out.println(lruCache.get(5)); // 输出: Five
        lruCache.printList();
        lruCache.put(6, "Six"); // 1被移除,因为最近没有使用
        lruCache.printList();
        System.out.println(lruCache.get(1)); // 输出: null
        lruCache.printList();
    }
}
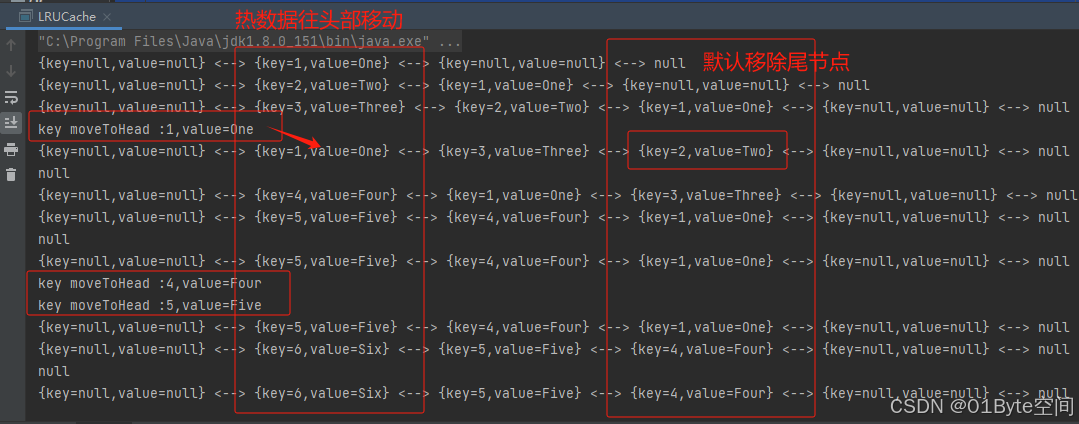
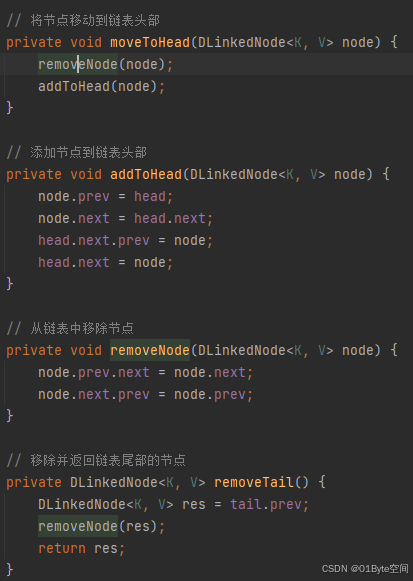
关键方法:get和put;以及moveToHead
get:命中key则往头部移动
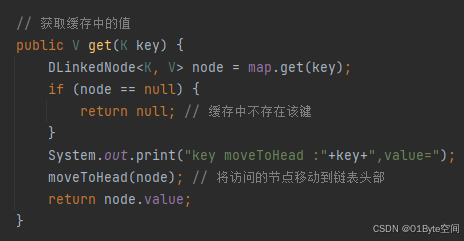
put方法:默认往头部插入新数据(如果key,value已存在,则将其移到头部),超过LRU长度则移除尾节点。
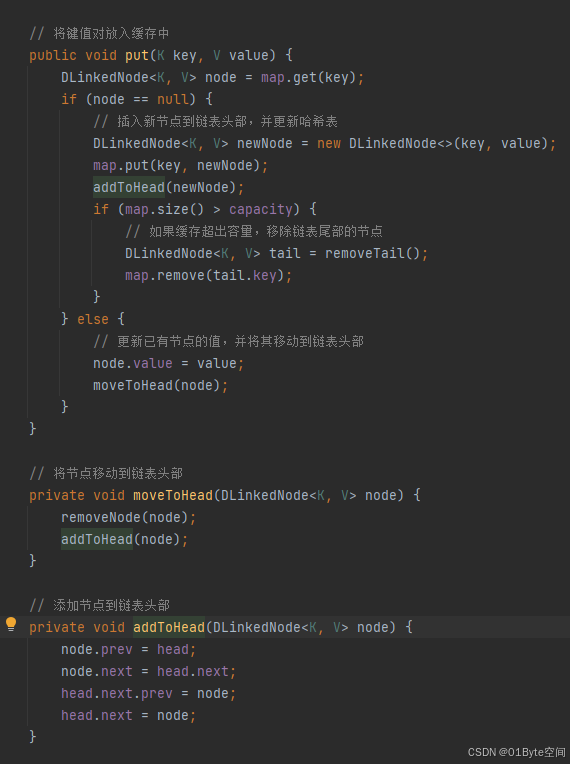
moveToHead:往头部移动热点数据

助力广东及东莞地区开发者,代码托管、在线学习与竞赛、技术交流与分享、资源共享、职业发展,成为松山湖开发者首选的工作与学习平台
更多推荐
 38
 0
- 0


 已为社区贡献4条内容

所有评论(0)