Spark学习(Pyspark)
(1)Spark基础入门
①什么是Spark
Spark是一款分布式内存计算的统一分析引擎。其特点就是对任意类型的数据进行自定义计算。Spark可以计算:结构化、半结构化、非结构化等各种类型的数据结构,同时也支持使用Python、Java、Scala、R以及SQL语言去开发应用程序计算数据。Spark的适用面非常广泛,所以,被称之为 统一的(适用面广)的分析引擎(数据处理)
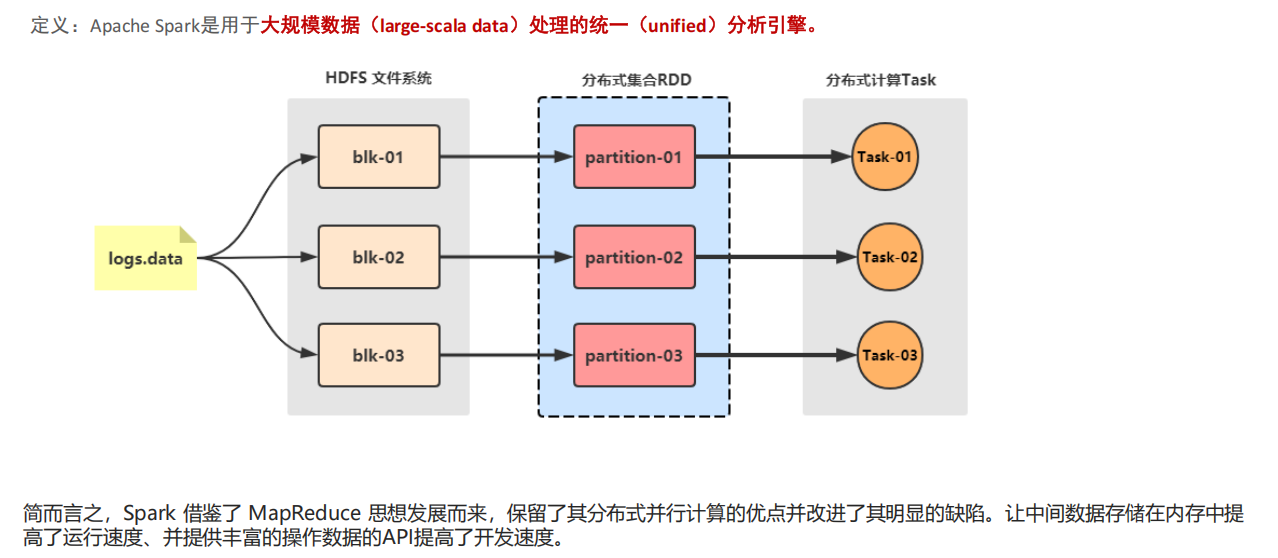
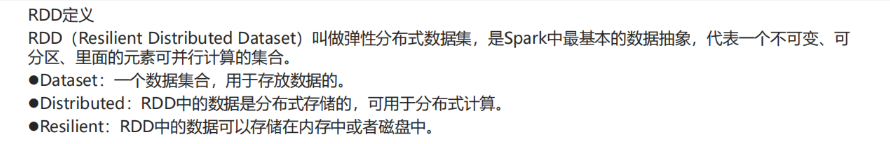
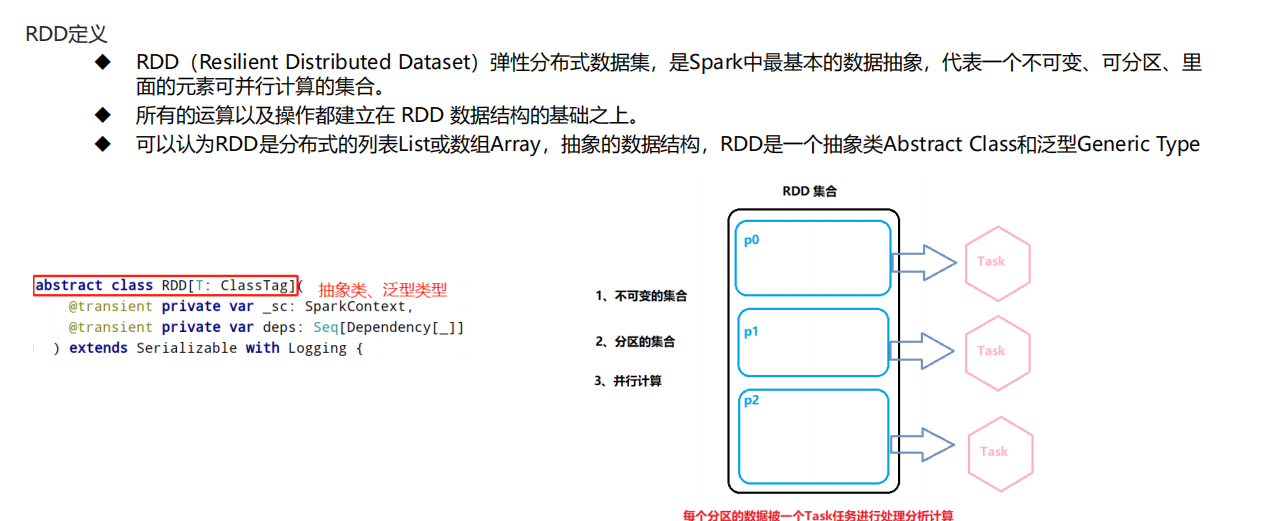
RDD 是一种分布式内存抽象,其使得程序员能够在大规模集群中做内存运算,并且有一定的容错方式。而这也是整个 Spark 的核心数据结构,Spark 整个平台都围绕着RDD进行。可以说RDD就是一种数据结构抽象。
RDD(Resilient Distributed Dataset),是指弹性分布式数据集。
①数据集:Spark中的编程是基于RDD的,将原始数据加载到内存变成RDD,RDD再经过若干次转化,仍为RDD。
②分布式:读数据一般都是从分布式系统中去读,如hdfs、kafka等,所以原始文件存在磁盘是分布式的,spark加载完数据的RDD也是分布式的,换句话说RDD是抽象的概念,实际数据仍在分布式文件系统中;因为有了RDD,在开发代码过程会非常方便,只需要将原始数据理解为一个集合,然后对集合进行操作即可
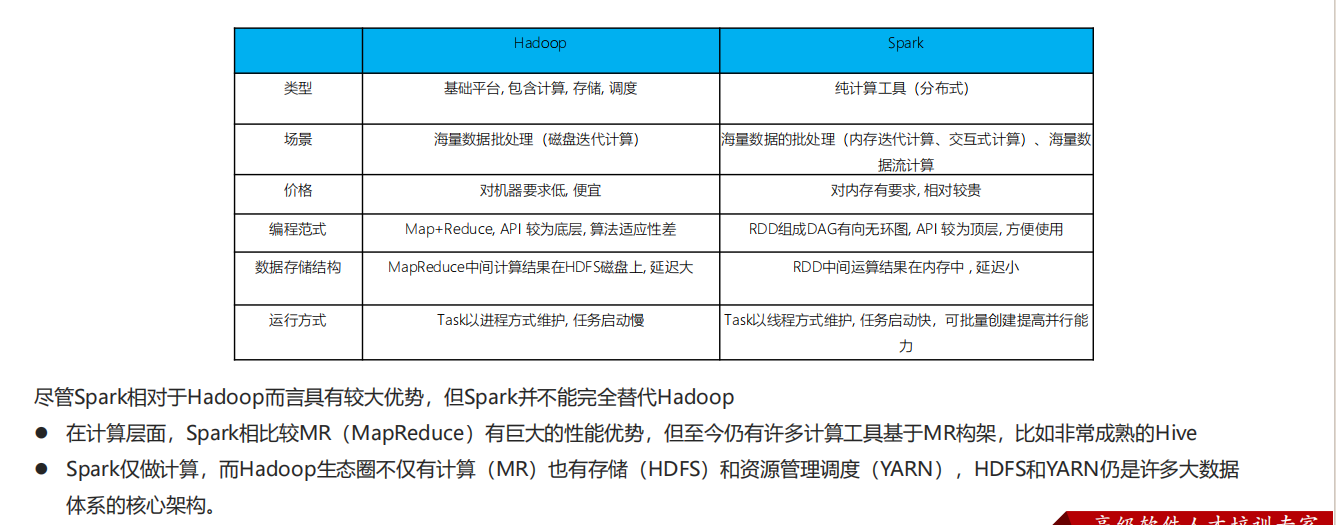
②Spark VS Hadoop(MapReduce)
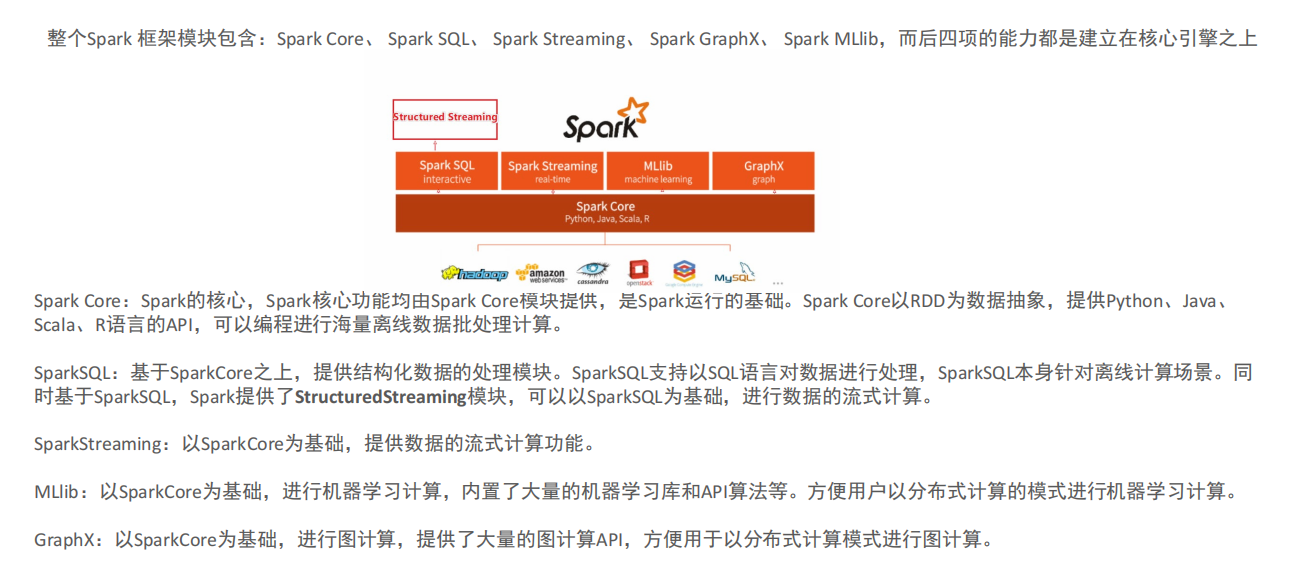
③Spark 框架模块
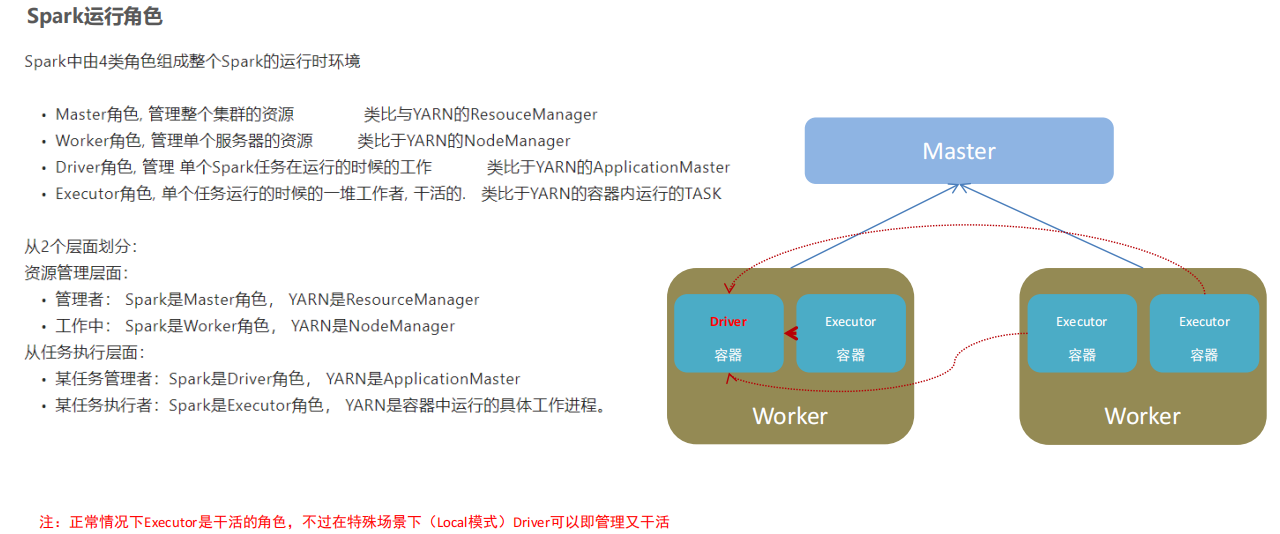
④Spark的架构角色
⑤Spark本地运行环境
"Local"指的是本地运行模式,即在单个机器上(而非集群)运行Spark应用程序的开发测试模式。这种模式允许开发者在没有分布式环境的情况下快速测试和调试Spark代码
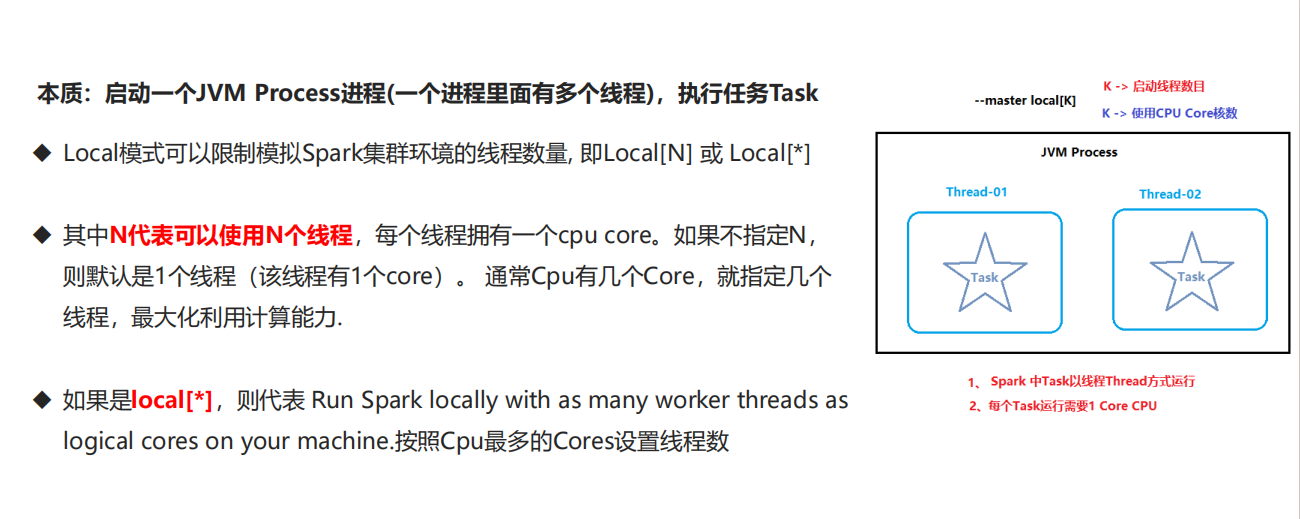
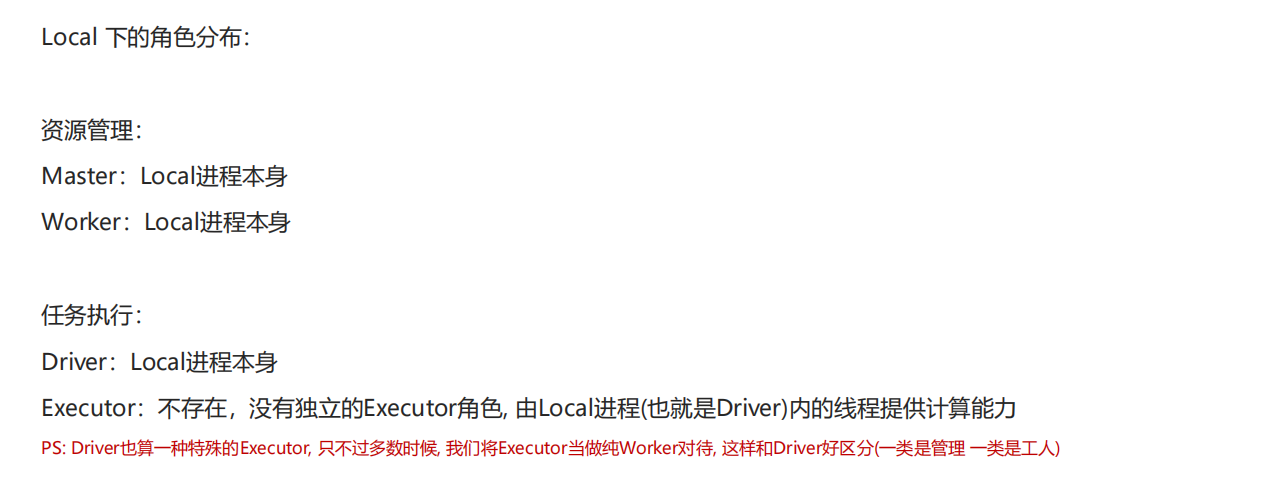
这种模式下面有三种运行方式:
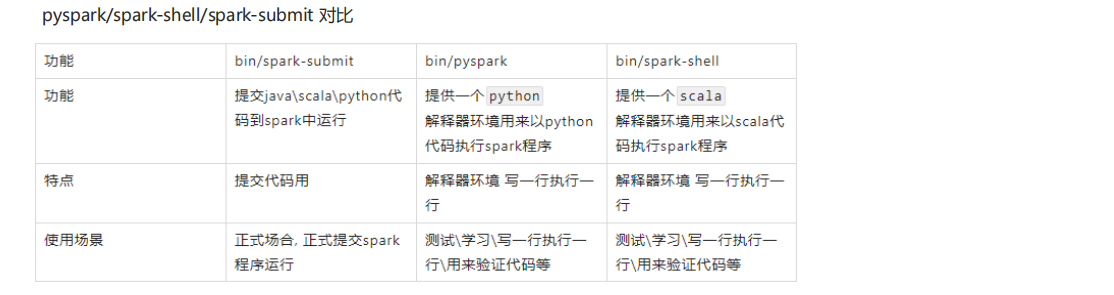
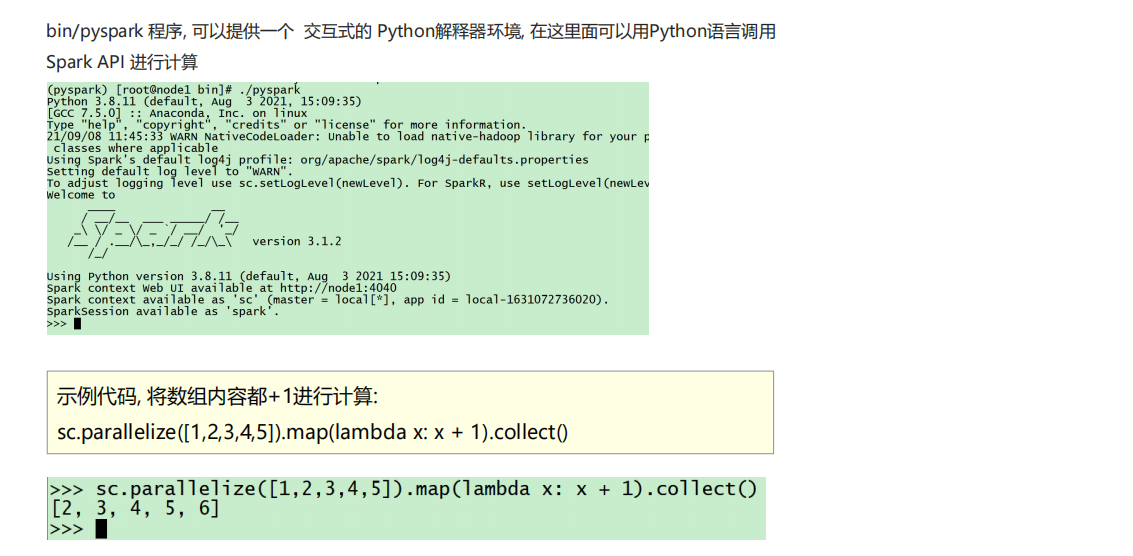
①以下是基于Pyspark的测试:
②以下是spark-submit的测试代码:
代码格式为:./spark-submit [可选的一些选项] jar包或者python代码的路径 [代码的参数]
示例如下:./spark-submit /opt/spark/examples/src/main/python/pi.py 10
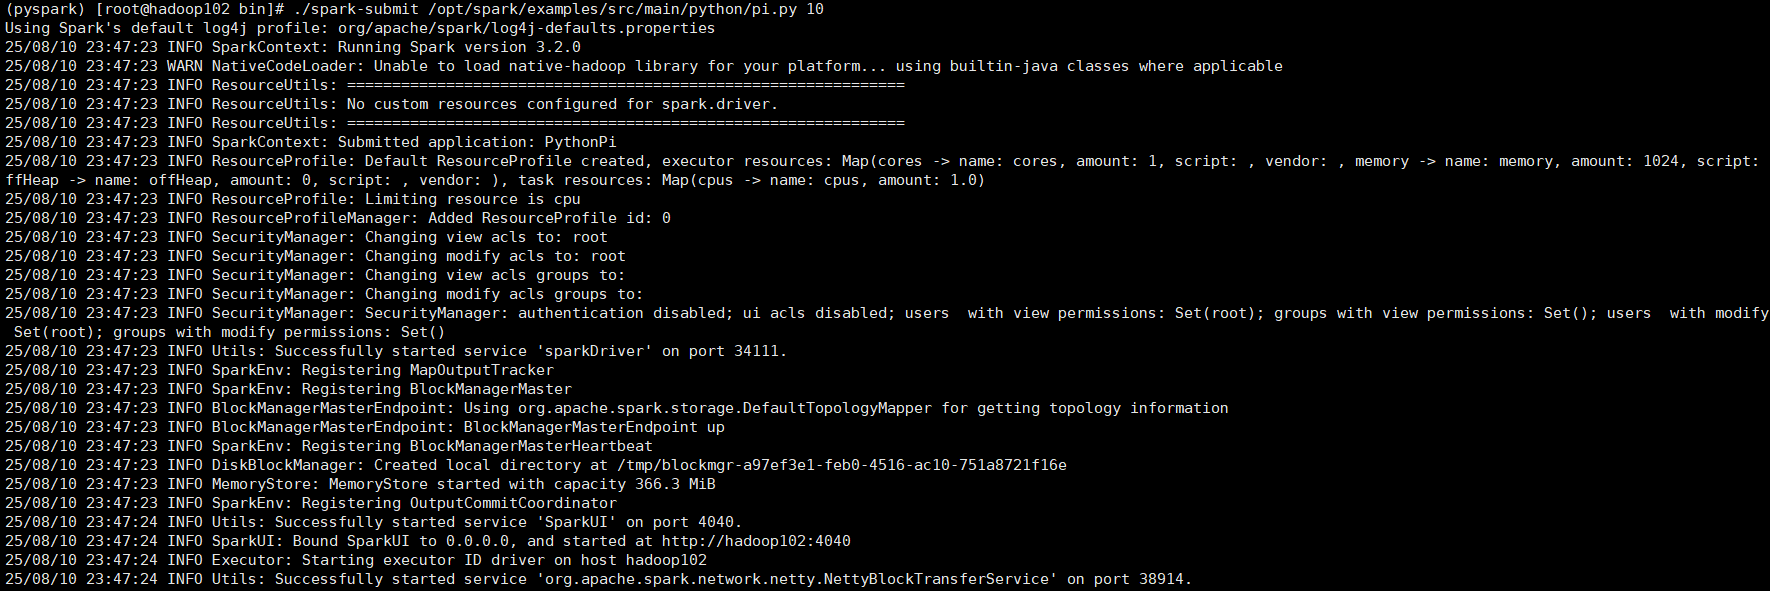
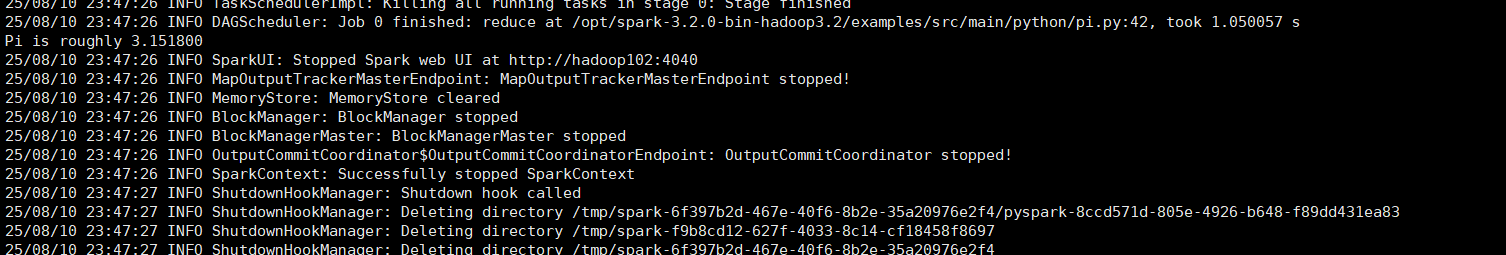
以下是总结:
①Local模式的运行原理:Local模式就是以一个独立进程配合其内部线程来提供完成Spark运行时环境. Local模式可以通过spark-shell/pyspark/spark-submit等来开启
②bin/pyspark是什么程序:**是一个交互式的解释器执行环境,环境启动后就得到了一个Local Spark环境,**可以运行Python代码去进行Spark计算,类似Python自带解释器
③Spark的4040端口是什么:Spark的任务在运行后,会在Driver所在机器绑定到4040端口,提供当前任务的监控页面供查看
(2)SparkCore
①RDD详解
分布式计算涉及到了以下步骤:
(1)分区控制:分区控制是将大规模数据集划分为多个逻辑分片(Partition),以便分布式并行处理。通过合理分区(如按Key哈希、范围划分等),可确保数据均匀分布,避免倾斜问题。例如,Spark的RDD、Flink的KeyedStream都依赖分区实现并行计算,分区数通常与并行度挂钩。
(2)Shuffle控制:Shuffle是跨节点数据重分布的过程,涉及数据的洗牌和重组。例如,在Reduce或Join操作时,相同Key的数据需聚合到同一节点,例如Spark的reduceByKey、Flink的keyBy都会触发Shuffle。
(3)数据存储\序列化\发送:分布式计算中,数据需高效存储(如HDFS、内存)、序列化(如Kryo、Protobuf)和跨节点传输。序列化影响网络开销,需权衡速度与体积;存储格式(如Parquet)影响I/O效率。数据传输依赖RPC或消息队列(如Netty),需考虑容错与流量控制。
(4)数据计算API:计算API提供分布式操作的编程接口(如Map、Reduce、Join),隐藏底层复杂性。API设计需兼顾表达能力与性能,如Spark的RDD,Flink的DataStream。
这些功能, 不能简单的通过Python内置的本地集合对象(如 List\ 字典等)去完成.我们在分布式框架中, 需要有一个统一的数据抽象对象, 来实现上述分布式计算所需功能.这个抽象对象, 就是RDD
RDD有5大特性:
①RDD是具有分区的。 ②RDD的方法会作用在所有分区上面。 ③RDD之间有互相依赖的关系
④Key-Value型的RDD可以有分区器 :只有PairRDD(元素是键值对(K, V)的RDD)才能显式指定分区器,因为分区逻辑通常基于Key的哈希或范围(如HashPartitioner或RangePartitioner)。非Key-Value型RDD(如普通数组)的分区是简单的轮询或随机分配,无需依赖Key的规则。
⑤RDD所在的分区规划会尽量靠近服务器以实现本地存储。
以下是以WordCount案例为核心分析RDD
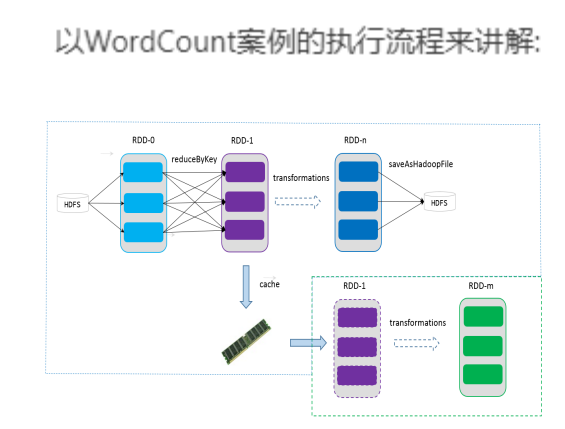
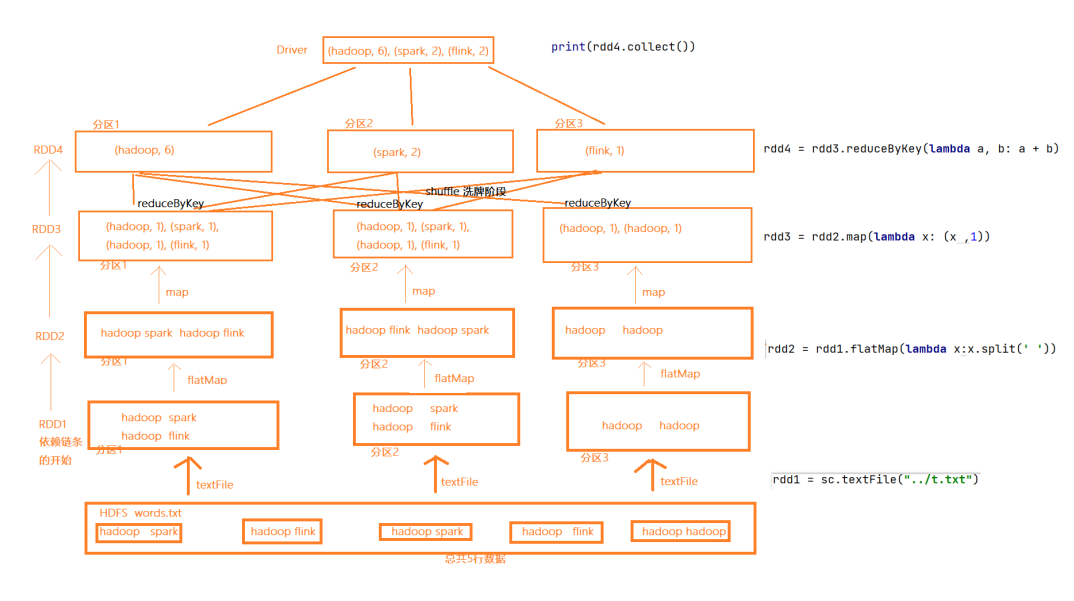
(2)RDD 编程入门
(1)程序执行入口 SparkContext对象:Spark RDD 编程的程序入口对象是SparkContext对象
   from pyspark import SparkConf, SparkContext
    conf = SparkConf().setAppName("WordCount").setMaster("spark://hadoop102:7077")
    # 前者是任务名字修改为你的 Master URL
    sc = SparkContext(conf=conf)

 (2)创建RDD的方法
    1 直接从集合对象创建
 	rdd = sparkcontext.parallelize(参数1,参数2)
	# 参数1 集合对象即可,比如lis    参数2 分区数
	data =[1,2,3,4,5,6,7,8,9]
	rdd =sc.parallelize(data,numSlices=3)
	rdd.getNumPartitions()        #获得分区数

	2 从文件当中读取
	resultRDD = sc.textFile("hdfs://hadoop102:8020/input/article.txt")

 (3)RDD算子
  1 Transformation算子:返回的还是rdd,参数是函数式接口
  	rdd = sc.parallelize([1, 2, 3, 4, 5])
	# 1. map: 对每个元素应用函数
	mapped = rdd.map(lambda x: x * 2)  # 输出: [2, 4, 6, 8, 10]

	# 2. flatMap: 先映射后扁平化(如拆分单词)
	words = sc.parallelize(["hello world", "spark demo"])
	flattened = words.flatMap(lambda x: x.split(" "))  # 输出: ["hello", "world", "spark", "demo"]

	# 3. filter: 过滤满足条件的元素
	filtered = rdd.filter(lambda x: x > 3)  # 输出: [4, 5]

	# 4. distinct: 去重
	distinct = sc.parallelize([1, 2, 2, 3]).distinct()  # 输出: [1, 2, 3]

	# 5. sample: 随机采样
	sampled = rdd.sample(withReplacement=False, fraction=0.5)  # 无放回采样50%数据

    接下来是对Key-value类型的RDD操作
	pair_rdd = sc.parallelize([("a", 1), ("b", 2), ("a", 3)])
	# 6. mapValues: 仅对Value映射
	upper_values = pair_rdd.mapValues(lambda v: v * 10)  # 输出: [("a", 10), ("b", 20), ("a", 30)]

	# 7. reduceByKey: 按Key聚合(优化版groupByKey)
	sum_by_key = pair_rdd.reduceByKey(lambda a, b: a + b)  # 输出: [("a", 4), ("b", 2)]

	# 8. groupByKey: 按Key分组(可能OOM)
 	grouped = pair_rdd.groupByKey()  # 输出: [("a", [1, 3]), ("b", [2])]

	# 9. sortByKey: 按Key排序
	sorted_rdd = pair_rdd.sortByKey(ascending=False)  # 降序输出: [("b", 2), ("a", 1), ("a", 3)]

	# 10. keys: 提取所有Key

	keys = pair_rdd.keys()  # 输出: ["a", "b", "a"]

	# 11. values: 提取所有Value
	values = pair_rdd.values()  # 输出: [1, 2, 3]

    多RDD操作
	rdd1 = sc.parallelize([1, 2, 3])
	rdd2 = sc.parallelize([3, 4, 5])

	# 12. union: 合并两个RDD(不去重)
	union_rdd = rdd1.union(rdd2)  # 输出: [1, 2, 3, 3, 4, 5]

	# 13. intersection: 返回交集
	intersection_rdd = rdd1.intersection(rdd2)  # 输出: [3]

	# 14. subtract: 返回rdd1有但rdd2没有的元素
	subtracted = rdd1.subtract(rdd2)  # 输出: [1, 2]

	# 15. cartesian: 笛卡尔积(慎用!)
	cartesian_rdd = rdd1.cartesian(rdd2)  # 输出: [(1,3), (1,4), ..., (3,5)]

	分区/重分区控制
	# 16. repartition: 全局重分区(全量Shuffle)
	repartitioned = rdd.repartition(4)  # 强制分成4个分区

	# 17. coalesce: 合并分区(减少分区,避免Shuffle)
	coalesced = rdd.coalesce(2)  # 合并为2个分区

	# 18. partitionBy: 按分区器重分(仅PairRDD)
	from pyspark.rdd import HashPartitioner
	partitioned = pair_rdd.partitionBy(HashPartitioner(3))  # 按Key哈希分到3个分区

  2 Action算子:
  1. 数据收集与输出
	rdd = sc.parallelize([1, 2, 3, 4, 5])
	# 1. collect(): 返回RDD所有元素到Driver(小心数据量!)
	result = rdd.collect()  # 输出: [1, 2, 3, 4, 5]

	# 2. take(n): 返回前n个元素
	first_two = rdd.take(2)  # 输出: [1, 2]

	# 3. first(): 返回第一个元素
	first_elem = rdd.first()  # 输出: 1

	# 4. takeSample(withReplacement, num, seed): 随机采样
	sampled = rdd.takeSample(False, 3)  # 无放回随机取3个元素,如 [2, 4, 1]

	# 5. takeOrdered(n, key=None): 按升序或自定义key返回前n个
	ordered = rdd.takeOrdered(3)  # 输出: [1, 2, 3]

	2. 统计与聚合
	# 6. count(): 返回RDD元素总数
	count = rdd.count()  # 输出: 5

	# 7. countByKey(): 统计每个Key的出现次数(仅PairRDD)
	pair_rdd = sc.parallelize([("a", 1), ("b", 2), ("a", 3)])
	key_counts = pair_rdd.countByKey()  # 输出: {"a": 2, "b": 1}

	# 8. countByValue(): 统计每个值的出现次数
	value_counts = rdd.countByValue()  # 输出: {1:1, 2:1, 3:1, 4:1, 5:1}

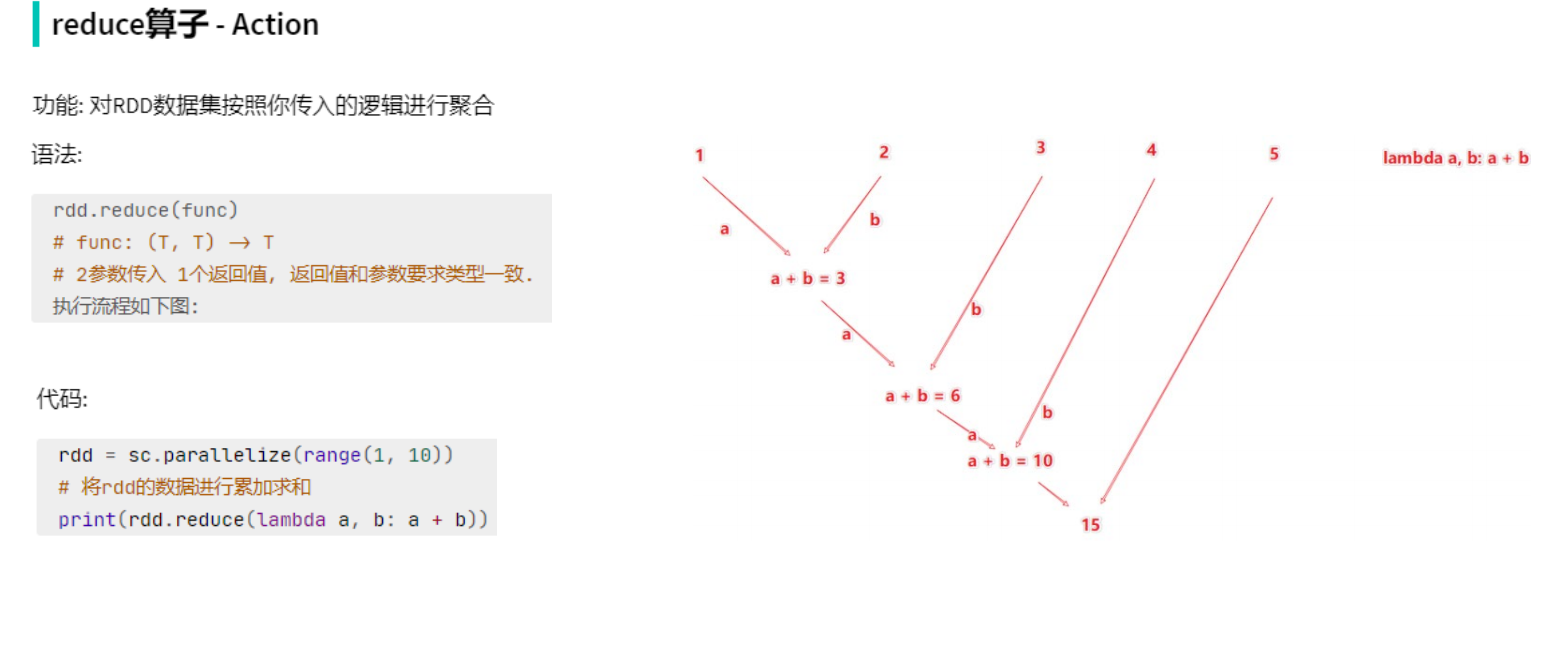
	# 9. reduce(func): 用func聚合所有元素(需满足结合律)
	sum_all = rdd.reduce(lambda a, b: a + b)  # 输出: 15 (1+2+3+4+5)

	# 10. fold(zeroValue, func): 类似reduce,但需初始值
	sum_with_zero = rdd.fold(0, lambda a, b: a + b)  # 输出: 15

	# 11. aggregate(zeroValue, seqOp, combOp): 自定义聚合
	agg_result = rdd.aggregate((0, 0),
    lambda acc, x: (acc[0] + x, acc[1] + 1),  # 分区内累加和计数
    lambda acc1, acc2: (acc1[0] + acc2[0], acc1[1] + acc2[1])  # 分区间合并)  # 输出: (15, 5) 总和和总个数

	3. 数据保存到外部存储
	# 12. saveAsTextFile(path): 保存为文本文件(每行一个元素)
	rdd.saveAsTextFile("output/")  # 生成目录,内含part-00000等文件

	# 13. saveAsSequenceFile(path): 保存为SequenceFile(仅PairRDD)
	pair_rdd.saveAsSequenceFile("seq_output/")

	# 14. saveAsHadoopFile/pickleFile等: 其他格式保存(需配置)

	4. 迭代与调试
	# 15. foreach(func): 对每个元素应用func(无返回值)
	rdd.foreach(lambda x: print(x))  # 打印每个元素(在Executor端执行)

	# 16. foreachPartition(func): 对每个分区应用func
	def log_partition(iterator):
    	print("Partition data:", list(iterator))
	rdd.foreachPartition(log_partition)  # 按分区打印数据
Reduce算子的图片:
(3)SparkSQL
①什么是SparkSQL
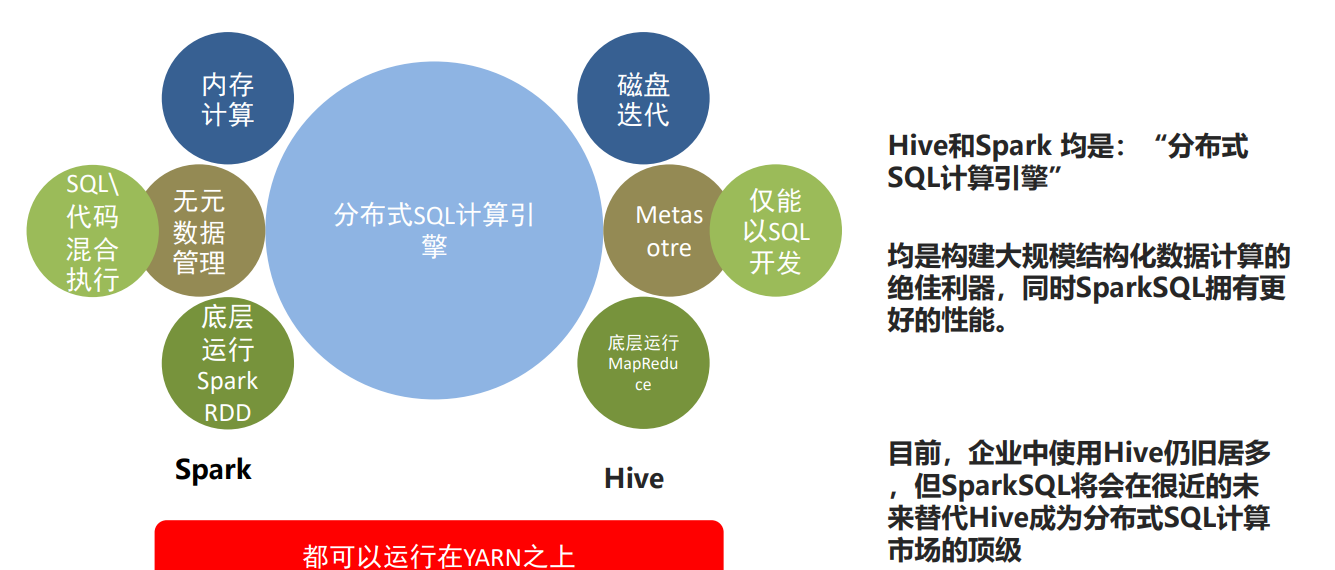
SparkSQL是非常成熟的 海量结构化数据处理框架。SparkSQL本身十分优秀, 支持SQL语言\性能强\可以自动优化\API简单\兼容HIVE等等。企业大面积在使用SparkSQL处理业务数据。例如:离线开发,数仓搭建,科学计算,数据分析。SparkSQL具有以下特点:
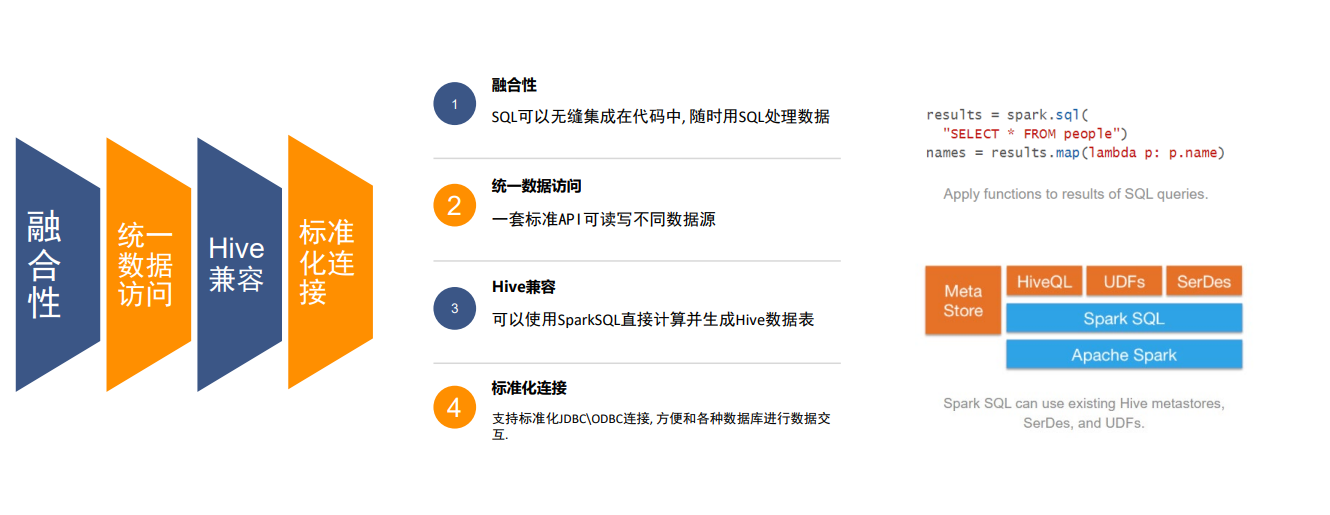
以下是SparkSQL和Hive的对比:
Spark的数据抽象如下:
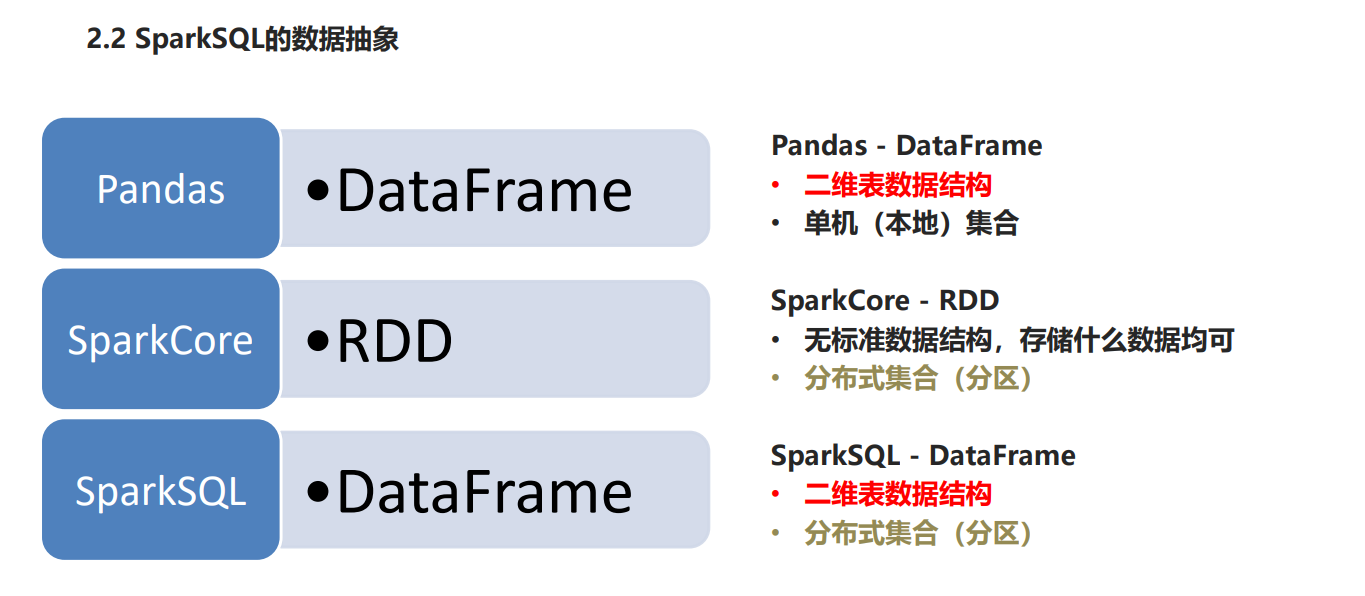
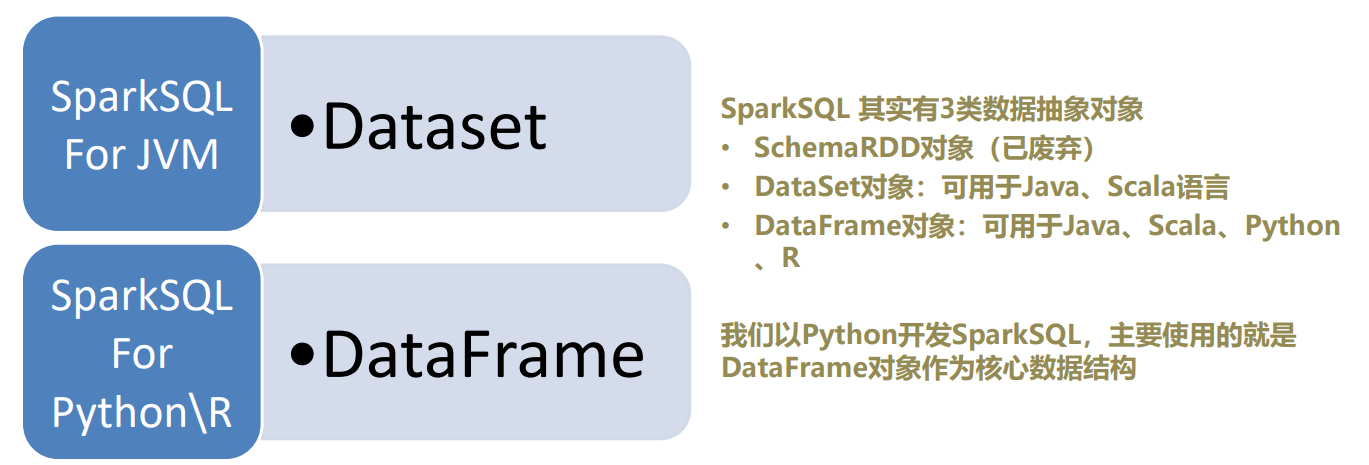
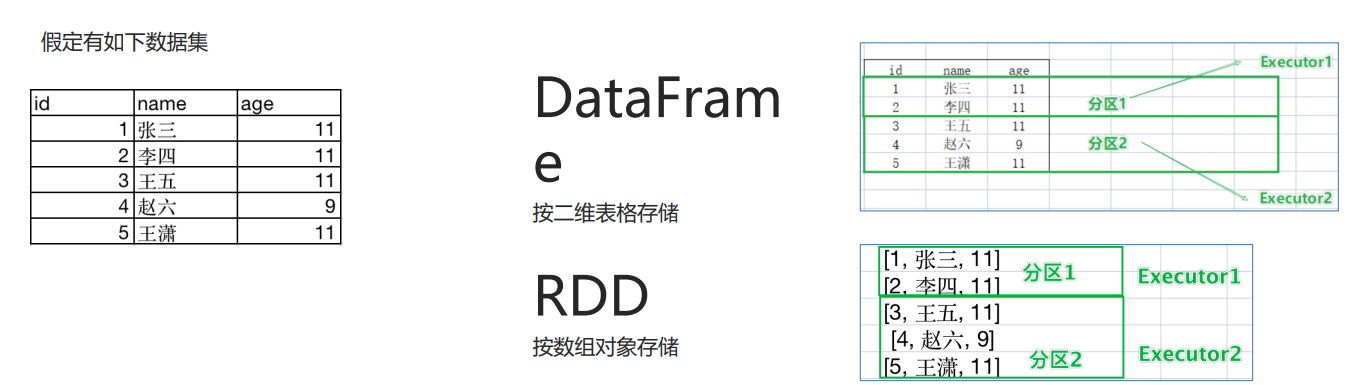
DataFrame 是按照二维表格的形式存储数据,RDD则是存储对象本身。具体对比如下:
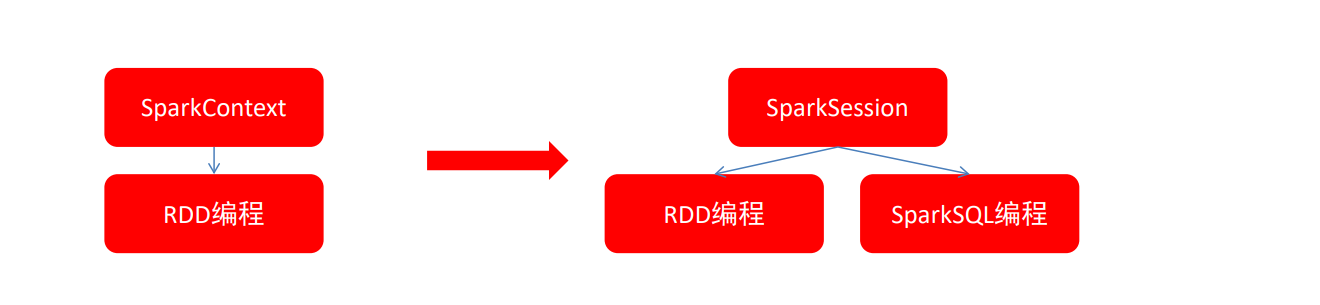
在RDD阶段,程序的执行入口对象是: SparkContext
在Spark 2.0后,推出了SparkSession对象,作为Spark编码的统一入口对象。SparkSession对象可以:
- 用于SparkSQL编程作为入口对象
- 用于SparkCore编程,可以通过SparkSession对象中获取到SparkContext
以下是代码:
# coding:utf8
# SparkSQL 中的入口对象是SparkSession对象
from pyspark.sql import SparkSession
if __name__ == '__main__':
# 构建SparkSession对象, 这个对象是 构建器模式 通过builder方法来构建
	spark = SparkSession.builder.\
	appName("local[*]").\
	config("spark.sql.shuffle.partitions", "4").\
	getOrCreate()
# appName 设置程序名称, config设置一些常用属性
# 最后通过getOrCreate()方法 创建SparkSession对象
(2)DataFrame入门
以下是DataFrame的总体结构:
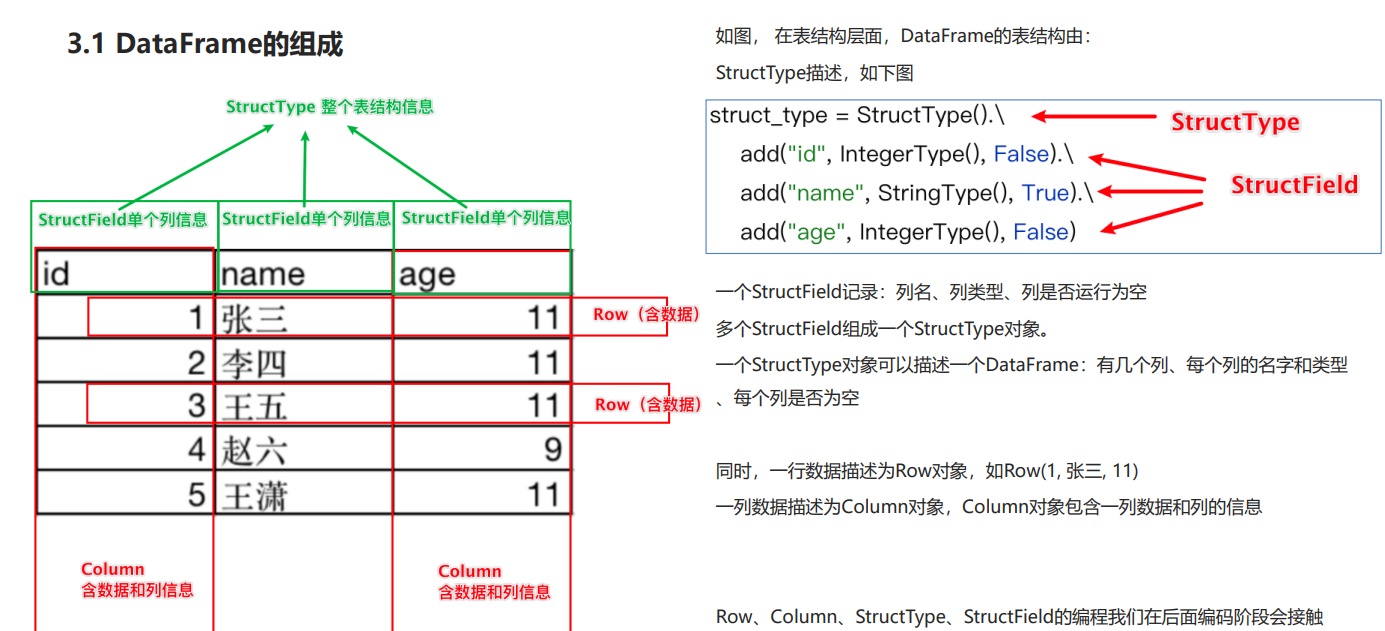
①以下是Dataframe的构建方式:
df = spark.createDataFrame(rdd, schema = ['name', 'age'])
#直接通过SparkSession对象的createDataFrame方法来将RDD转换为DataFrame:

# StructType 类这个类 可以定义整个DataFrame中的Schema
schema = StructType().\
add("id", IntegerType(), nullable=False).\
add("name", StringType(), nullable=True).\
add("score", IntegerType(), nullable=False)
df = spark.createDataFrame(rdd, schema)
# 一个add方法 定义一个列的信息, 如果有3个列, 就写三个add, 每一个add代表一个StructField# add方法: 参数1: 列名称, 参数2: 列类型, 参数3: 是否允许为空

#调用RDD的todf方法转变
df = rdd.toDF(['id', 'subject', 'score'])    #列名
df = rdd.toDF(schema)                        #传入schema

#基于自定义的pandas的DF,构建Pandas的DF,而后把将Pandas的DF对象转换成Spark的DF
pdf = pd.DataFrame({
"id": [1, 2, 3],
"name": ["张大仙", '王晓晓', '王大锤'],"age": [11, 11, 11]
})
df = spark.createDataFrame(pdf)

#sparksession读取外部数据
sparksession.read.format("text|csv|json|parquet|orc|avro|jdbc|......")
.option("K", "V") # option可选
.schema(StructType | String)
.load("被读取文件的路径, 支持本地文件系统和HDFS")

示例代码如下:
1 text文件
schema = StructType().add("data", StringType(), nullable=True)
df = spark.read.format("text")\
.schema(schema)\
.load("../data/sql/people.txt")

2 json文件
df = spark.read.format("json").\
load("../data/sql/people.json")
# JSON 类型 一般不用写.schema, json自带, json带有列名 和列类型(字符串和数字)df.printSchema()

3 csv文件
df = spark.read.format("csv")\
.option("sep", ";")\ # 列分隔符
.option("header", False)\ # 是否有CSV标头
.option("encoding", "utf-8")\ # 编码
.schema("name STRING, age INT, job STRING")\ # 指定列名和类型
.load("../data/sql/people.csv") # 路径

4 parquet数据
# parquet 自带schema, 直接load啥也不需要了
df = spark.read.format("parquet").\
load("../data/sql/users.parquet")
②以下是DataFrame的基本操作方式
DSL:领域特定语言。其实就是指DataFrame的特有API比如:df.where().limit()
SQL风格就是使用SQL语句处理DataFrame的数据比如:spark.sql(“SELECT * FROM xxx)
(1)DSL语法风格
# 1. 基本操作示例
df.show()  # 展示 DataFrame 的前20行数据# 打印 DataFrame 的 schema
df.printSchema()  # 以树形结构打印 DataFrame 的列名和数据类型
columns = df.columns  # 获取 DataFrame 的所有列名列表
dtypes = df.dtypes  # 获取列名和对应数据类型的元组列表
schema = df.schema  # 获取 DataFrame 的完整 schema 信息
row_count = df.count()  # 计算 DataFrame 中的总行数
stats = df.describe()  # 对数值列计算 count, mean, stddev, min, max

# 2. 列操作示例

selected = df.select("name", "age")  # 只选择 name 和 age 两列
new_df = df.withColumn("age_plus_10", col("age") + 10)  # 创建新列 age_plus_10
renamed_df = df.withColumnRenamed("old_name", "new_name")  # 将 old_name 列改名为 new_name
dropped_df = df.drop("unwanted_column")  # 删除 unwanted_column 列

# 3. 过滤和排序示例

filtered_df = df.filter(col("age") > 18)  # 筛选 age 大于18的行
distinct_df = df.distinct()  # 去除完全相同的重复行
sorted_df = df.orderBy("age", ascending=False)  # 按 age 降序排列
limited_df = df.limit(100)  # 只返回前100行数据

# 4. 聚合操作示例
grouped_df = df.groupBy("department")  # 按 department 列分组
agg_df = df.agg(avg("salary").alias("avg_salary"))  # 计算 salary 列的平均值
count_df = df.groupBy("department").count()  # 计算每个部门的记录数
sum_df = df.groupBy("product").sum("sales")  # 计算每个产品的总销售额
avg_df = df.groupBy("class").avg("score")  # 计算每个班级的平均分
max_df = df.groupBy("year").max("temperature")  # 获取每年的最高温度
min_df = df.groupBy("month").min("price")  # 获取每月的最低价格
pivot_df = df.groupBy("date").pivot("category").sum("value")  # 创建按日期和类别的透视表

# 5. 连接操作示例
## 内连接
joined_df = df1.join(df2, df1.id == df2.id, "inner")  # 基于 id 列的内连接,还有其他连接
union_df = df1.union(df2)  # 垂直合并两个结构相同的 DataFrame
union_by_name_df = df1.unionByName(df2)  # 按列名合并,允许列顺序不同

# 6. 窗口函数示例
## 定义窗口分区
window_spec = Window.partitionBy("department").orderBy("salary")  # 按部门分区并按工资排序
ranked_df = df.withColumn("rank", rank().over(window_spec))  # 计算每个部门内的工资排名
lag_df = df.withColumn("prev_salary", lag("salary").over(window_spec))  # 获取前一行的工资值

# 7. 缺失值处理示例
## 填充缺失值
filled_df = df.na.fill(0)  # 将所有空值填充为0
dropped_na_df = df.na.drop()  # 删除包含任何空值的行
replaced_df = df.na.replace(["old_value"], ["new_value"], "column_name")  # 替换指定列中的特定值

# 8. 数据类型转换示例
casted_df = df.withColumn("age_int", col("age").cast("integer"))  # 将 age 列转为整数类型

# 9. 写入操作示例
df.write.csv("output.csv")  # 将 DataFrame 写入 CSV 文件
df.write.parquet("output.parquet")  # 将 DataFrame 写入 Parquet 文件

# 10. 其他常用操作示例
cached_df = df.cache()  # 将 DataFrame 缓存到内存中
repartitioned_df = df.repartition(10)  # 将数据重新分区为10个分区
coalesced_df = df.coalesce(2)  # 将分区数减少到2个
df.explain()  # 打印 DataFrame 的执行计划
sampled_df = df.sample(0.1)  # 随机采样10%的数据
data = df.collect()  # 将所有数据收集到驱动程序节点
pandas_df = df.toPandas()  # 将 Spark DataFrame 转为 pandas DataFrame

(2)SQL风格:DataFrame的一个强大之处就是我们可以将它看作是一个关系型数据表,
然后可以通过在程序中使用spark.sql() 来执行SQL语句查询,结果返回一个DataFrame
如果想使用SQL风格的语法,需要将DataFrame注册成表,采用如下的方式:
df.createTempView("score") # 注册一个临时视图(表)
df.create0rReplaceTempView(“score") #注册一个临时表,如果存在进行替换
df.createGlobalTempView("score")# 注册一个全局表
以下是示例:SQL风格处理, 以RDD为基础做数据加载
#注册sparktext和sparksession对象
spark = SparkSession.builder.\appName("create df").\
master("local[*]").\
getOrCreate()
sc = spark.sparkContext

#读取数据
rdd = sc.textFile("hdfs://node1:8020/input/words.txt").\
flatMap(lambda x: x.split(" ")).\
map(lambda x: [x])
df = rdd.toDF(["word"]
df.createTempView("words")

# 使用sql语句处理df注册的表
spark.sql("""
SELECT word, COUNT(*) AS cnt FROM words GROUP BY word ORDER BY cnt DESC
""").show()

(3)数据清洗API:
#去重API dropDuplicates,无参数是对数据进行整体去重
df.dropDuplicates().show()
# API 同样可以针对字段进行去重,如下传入age字段,表示只要年龄一样 就认为你是重复数据
df.dropDuplicates(['age','job']).show()

# 如果有缺失,进行数据删除
#无参数 为 how=any执行,只要有一个列是null 数据整行删除,如果填入how='all'表示全部列为空 才会删除,how参数默认是a
df.dropna().show()
#指定阀值进行删除,thresh=3表示,有效的列最少有3个,这行数据才保留设定thresh后,how参数无效了
df.dropna(thresh=3).show()

# 可以指定阀值 以及配合指定列进行工作,thresh=2,subset=['name','age'〕表示 针对这2个列,有效列最少为2个才保留数据。
df.dropna(thresh=2,subset=['name','age']).show()

# 将所有的空,按照你指定的值进行填充,不理会列的任何空都被填充
df.fillna("loss").show()
#指定列进行填充
df.fillna("loss",subset=['job']).show()
# 给定字典 设定各个列的填充规则
df.fillna({"name":"未知姓名","age":1,"job":"worker"}).show()

(4)DataFrame写出:
df.write.mode().format().option(K,V).save(PATH)
# mode,传入模式字符串可选:append 追加,overwrite 覆盖,ignore 忽略,error 重复就报异常
# format,传入格式字符串,可选:text,csV,json,parquet,orc,avro,jdbc
# 注意text源只支持单列df写出
# option 设置属性,如:.option("sep",",")r
# save 写出的路径,支持本地文件和HDFS

下面是例子:
# Write text 写出,只能写出一个单列数据
df.select(F.concat_ws("_--","user id","movie_id", "rank", "ts")).\
write.\
mode("overwrite").\
format("text").\
save("../data/output/sql/text")

# WriteCSV写出
df.write.mode("overwrite").\
format("csv").\
option("sep",",").\
option("header",True).\
save("../data/output/sql/csv")

#Write Json写出
df.write.mode("overwrite").\
format("json").\
save("../data/output/sql/json")

#Write Parquet 写出
df.write.mode("overwrite").\format("parquet").\
save("../data/output/sql/parquet")

#不给format,默认以 parquet写出
df.write.mode("overwrite").save("../data/output/sql/default")

(5)DataFrame 通过JDBC读写数据库
# 写DF通过JDBC到数据库中
df.write.mode("overwrite").\
format("jdbc").\
option("url","jdbc:mysql://node1:3306/test?useSSL=false&useUnicode=true").\
option("dbtable","u data").\
option("user","root").\
option("password","123456").\
save()

#从数据库里面通过JDBC加载数据
df = spark.read.format("jdbc').\
option("url","jdbc:mysql://node1:3306/test?useSSL=false&useUnicode=true").\
option("dbtable","u data").\
option("user","root").\
option("password",“123456").\
load()
(3)Spark函数定义
①UDF函数
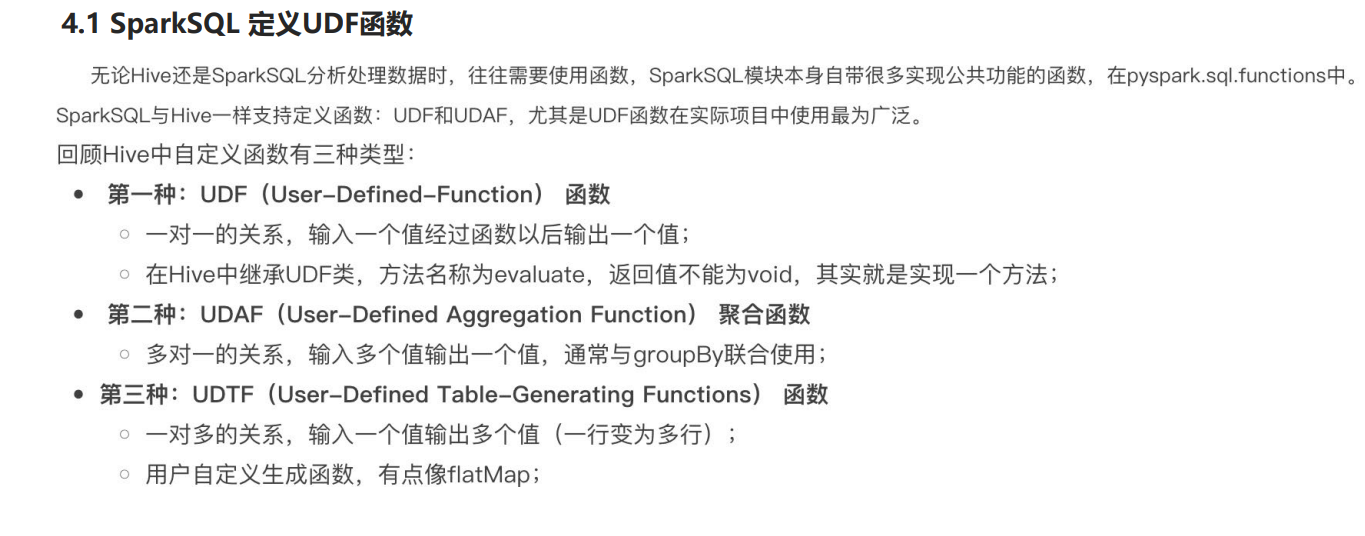
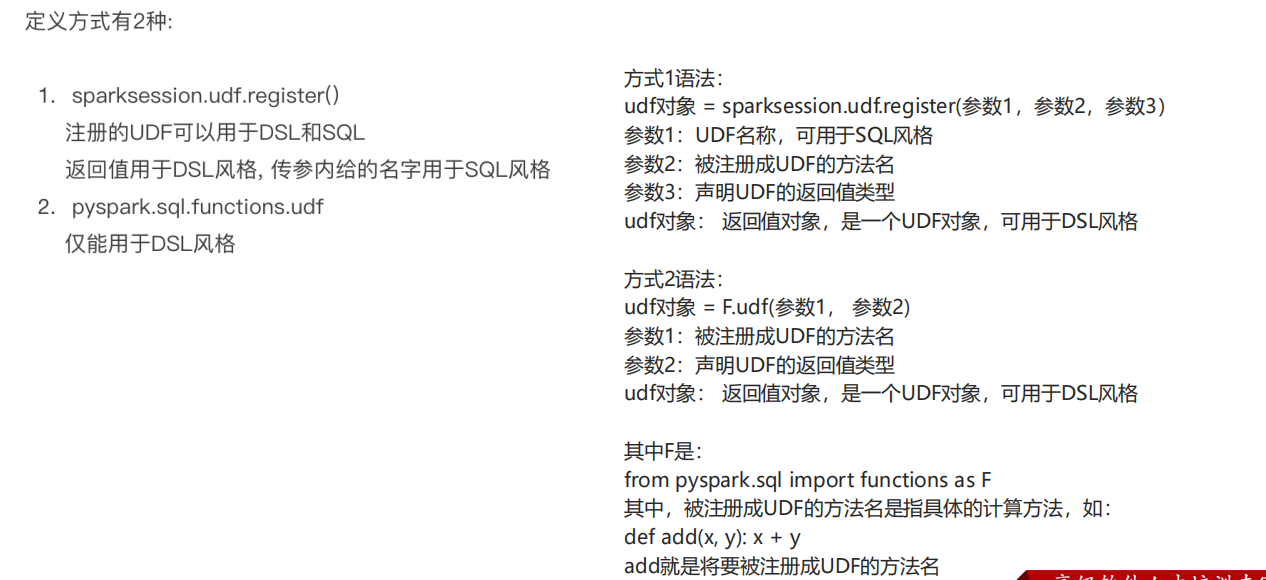
以下是代码:
方法1
from pyspark.sql import SparkSession
from pyspark.sql.types import IntegerType
# 创建SparkSession
spark = SparkSession.builder.appName("UDF_Example").getOrCreate()
# 定义普通Python函数
def add_numbers(x, y):
    return x + y

# 注册UDF - 方式1
add_udf = spark.udf.register("add_udf_name", add_numbers, IntegerType())
# 使用SQL风格
spark.sql("CREATE TEMPORARY VIEW numbers AS SELECT 5 as num1, 10 as num2")
spark.sql("SELECT add_udf_name(num1, num2) as result FROM numbers").show()

# 使用DSL风格
from pyspark.sql import functions as F
df = spark.createDataFrame([(5, 10)], ["num1", "num2"])
df.select(add_udf(F.col("num1"), F.col("num2")).alias("result")).show()

方法2
from pyspark.sql import SparkSession
from pyspark.sql import functions as F
from pyspark.sql.types import StringType

# 创建SparkSession
spark = SparkSession.builder.appName("UDF_Example").getOrCreate()

# 定义普通Python函数
def greet(name):
    return f"Hello, {name}!"

# 注册UDF - 方式2
greet_udf = F.udf(greet, StringType())

# 使用DSL风格
df = spark.createDataFrame([("Alice",), ("Bob",)], ["name"])
df.select(greet_udf(F.col("name")).alias("greeting")).show()
②SparkSQL的窗口函数:PySpark的窗口函数(Window Functions)是一种在数据集的特定窗口范围内执行计算的高级函数,它能在保留原始数据行的同时,对分组内的数据进行排序、聚合和分析。窗口函数的核心作用是为每一行计算基于其"窗口"(由PARTITION BY定义的分组和ORDER BY定义的排序)的衍生值,例如排名、累计和、移动平均等。与普通聚合函数不同,窗口函数不会减少数据行数,而是为每行添加新的计算列,保持原始数据的完整性。
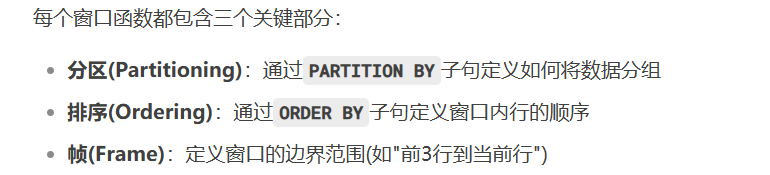
PS:一个添加列的函数
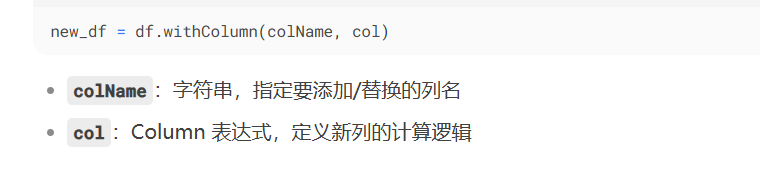
代码如下:
from pyspark.sql import functions as F
# 添加常量列
df = df.withColumn("country", F.lit("China"))

# 基于现有列计算
df = df.withColumn("total_price", F.col("price") * F.col("quantity"))

# 将salary列转换为千元单位
df = df.withColumn("salary", F.col("salary") / 1000)

# 修改数据类型
df = df.withColumn("age", F.col("age").cast("integer"))

# 添加部门内薪水排名
window_spec = Window.partitionBy("department").orderBy(F.desc("salary"))
df = df.withColumn("dept_rank", F.rank().over(window_spec))

df = df.withColumn("salary_level",
                  F.when(F.col("salary") > 10000, "high")
                   .when(F.col("salary") > 5000, "medium")
                   .otherwise("low"))
以下是窗口函数的应用:
from pyspark.sql import SparkSession
from pyspark.sql import functions as F
from pyspark.sql.window import Window
from pyspark.sql.types import StructType, StructField, StringType, IntegerType, DoubleType

# 初始化SparkSession
spark = SparkSession.builder \
    .appName("WindowFunctionsDemo") \
    .getOrCreate()

# 创建示例数据
data = [
    ("Sales", "John", 5000, "2023-01-15"),
    ("Sales", "Mike", 4500, "2023-01-10"),
    ("Sales", "Lisa", 6000, "2023-01-20"),
    ("IT", "Tom", 5500, "2023-01-12"),
    ("IT", "Emma", 7000, "2023-01-18"),
    ("IT", "Alex", 5200, "2023-01-05"),
    ("HR", "Sarah", 4800, "2023-01-08"),
    ("HR", "David", 5300, "2023-01-22")
]

schema = StructType([
    StructField("department", StringType(), True),
    StructField("employee", StringType(), True),
    StructField("salary", IntegerType(), True),
    StructField("date", StringType(), True)
])

df = spark.createDataFrame(data, schema)

# 定义窗口规范 - 按部门分区并按薪水排序
window_spec_by_salary = Window.partitionBy("department").orderBy("salary")

# 定义窗口规范 - 按部门分区并按日期排序
window_spec_by_date = Window.partitionBy("department").orderBy("date")

# 定义窗口规范 - 按部门分区(不排序)
window_spec_partition_only = Window.partitionBy("department")

# 定义行范围窗口 - 当前行及其前后1行
window_spec_rows = Window.partitionBy("department").orderBy("salary").rowsBetween(-1, 1)

# 定义无界窗口 - 从分区开始到当前行
window_spec_unbounded = Window.partitionBy("department").orderBy("date").rowsBetween(Window.unboundedPreceding, Window.currentRow)

# ====================== 排名函数 ======================

# 1. ROW_NUMBER() - 为每行分配唯一序号(相同值不同序号)
df = df.withColumn("row_num", F.row_number().over(window_spec_by_salary))

# 2. RANK() - 为行分配排名(相同值相同排名,留空位)
df = df.withColumn("rank", F.rank().over(window_spec_by_salary))

# 3. DENSE_RANK() - 为行分配排名(相同值相同排名,不留空位)
df = df.withColumn("dense_rank", F.dense_rank().over(window_spec_by_salary))

# 4. PERCENT_RANK() - 计算行的相对排名(0到1之间)
df = df.withColumn("percent_rank", F.percent_rank().over(window_spec_by_salary))

# 5. NTILE(n) - 将行分成n组并分配组号
df = df.withColumn("ntile_4", F.ntile(4).over(window_spec_by_salary))  # 分成4组

# ====================== 分析函数 ======================

# 6. LAG(col, offset, default) - 获取前offset行的值
df = df.withColumn("prev_salary", F.lag("salary", 1).over(window_spec_by_date))

# 7. LEAD(col, offset, default) - 获取后offset行的值
df = df.withColumn("next_salary", F.lead("salary", 1).over(window_spec_by_date))

# 8. FIRST_VALUE(col) - 获取窗口中的第一个值
df = df.withColumn("first_salary", F.first_value("salary").over(window_spec_by_date))

# 9. LAST_VALUE(col) - 获取窗口中的最后一个值
df = df.withColumn("last_salary", F.last_value("salary").over(window_spec_by_date))

# 10. CUME_DIST() - 计算行的累积分布(0到1之间)
df = df.withColumn("cume_dist", F.cume_dist().over(window_spec_by_salary))

# ====================== 聚合函数 ======================

# 11. SUM() OVER - 计算窗口内总和
df = df.withColumn("sum_salary", F.sum("salary").over(window_spec_partition_only))

# 12. AVG() OVER - 计算窗口内平均值
df = df.withColumn("avg_salary", F.avg("salary").over(window_spec_partition_only))

# 13. MIN() OVER - 找出窗口内最小值
df = df.withColumn("min_salary", F.min("salary").over(window_spec_partition_only))

# 14. MAX() OVER - 找出窗口内最大值
df = df.withColumn("max_salary", F.max("salary").over(window_spec_partition_only))

# 15. COUNT() OVER - 计算窗口内行数
df = df.withColumn("count_emp", F.count("employee").over(window_spec_partition_only))

# ====================== 高级窗口函数 ======================

# 16. 移动平均 - 当前行及其前后1行
df = df.withColumn("moving_avg", F.avg("salary").over(window_spec_rows))

# 17. 累计总和 - 从分区开始到当前行
df = df.withColumn("running_total", F.sum("salary").over(window_spec_unbounded))

# 18. 按值范围计算 - 当前值±500的范围
window_spec_range = Window.partitionBy("department").orderBy("salary").rangeBetween(-500, 500)
df = df.withColumn("range_avg", F.avg("salary").over(window_spec_range))

# 显示结果
df.orderBy("department", "salary").show(truncate=False)

# 停止SparkSession
spark.stop()

助力广东及东莞地区开发者,代码托管、在线学习与竞赛、技术交流与分享、资源共享、职业发展,成为松山湖开发者首选的工作与学习平台
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)