登录社区云,与社区用户共同成长
邀请您加入社区
Linux│├─ Java│├─ Hadoop│├─ MySQL│├─ Kafka│这是Spark / Flink / 大数据课程实验的基础环境。
本文围绕Apache Spark展开大数据分析从理论到实践的全面讲解,阐述Spark以内存计算、多语言支持、一站式处理等优势,成为主流大数据引擎。文章系统介绍Spark核心特性、技术组件与标准分析流程,涵盖环境搭建、数据读取、清洗、计算、存储及优化全环节。基于PySpark构建5000万级电商销售数据分析实战案例,实现整体概况、区域、品类、时间趋势及高价值订单挖掘,并完成可视化与业务解读。同时梳理
通常情况下,我们使用Kafka构建系统或应用程序之间的数据管道,用来转换或响应实时数据,使数据能够及时的进行业务计算,得出相应结果。也许生活中偶有黯淡无光的时刻,但别忘了还有未实现的梦想,努力朝着自己的目标一点点前进。Kafka集群部署依赖于Java环境和Zookeeper服务,在本书第二章搭建Spark HA小节,我们已经完成了上述环境和Zookeeper集群的配置。上述命令执行成功后,如果控制
本文介绍了一个基于Spark的银行ETL系统设计方案,用于处理每日海量账户余额数据。系统从TXT文件中提取数据,经过多级处理(包括数据清洗、缺失值补充、重复数据处理等业务逻辑)后,将结果存储到PostgreSQL数据库。方案采用双表存储策略(历史表和最新余额表),并详细说明了Spark在分布式计算、业务规则实现和数据质量保障方面的优势。文章还提供了性能优化策略、异常处理机制和监控方案,强调在金融系
本次项目以Spark为核心完成新能源车数据的分布式分析,利用Flask搭建Web服务,结合协同过滤算法实现了个性化推荐,覆盖了数据处理、算法实现、Web开发全流程;项目代码可直接复用,通过调整数据集和参数,可适配不同行业(如电商、影视)的推荐场景;核心价值在于将大数据分析与实际业务场景结合,既体现了Spark的分布式计算能力,又通过Flask实现了算法的工程化落地。
【代码】大数据技术演进(从传统Hadoop到Spark到云原生的技术演进路径)
本文介绍了Spark中三种常用Action算子:first、collect和collectAsMap的使用方法。first算子用于获取RDD中的第一个元素,相当于take(1)操作;collect算子将RDD所有数据收集到Driver端返回数组;collectAsMap专门处理键值对RDD,将其转换为Map结构返回。文章分别提供了Java和Scala两种语言的实现代码示例,包括环境配置、算子调用和
地区空气质量数据分析系统是一个基于大数据和深度学习的智能空气质量监测与预测平台。系统采用Apache Spark进行高效的大规模数据预处理,利用TensorFlow构建LSTM深度学习模型实现精准的AQI预测,通过Flask框架提供RESTful API服务,结合Bootstrap和ECharts打造直观的可视化界面。系统采用前后端分离架构,包含用户端和管理端两大模块,用户端面向公众提供实时空气质
摘要:本文介绍了Spark中的两个重要Action算子:foreachPartition和count。foreachPartition以分区为单位遍历数据,适用于批量操作场景(如数据库连接),相比foreach能显著提高效率。count则用于统计RDD中的元素总数。文章通过Java和Scala代码示例展示了两种算子的具体用法,并强调Action算子会触发实际计算(与Transformations的
本文介绍了一个基于大数据技术的睡眠质量与压力水平分析系统。系统采用Python开发,整合了Spark、Hadoop等分布式计算框架,结合MySQL数据库存储数据,使用Django后端和Vue+Echarts前端构建可视化界面。系统包含8个核心功能模块:综合健康指数趋势、压力水平指标均值分析、生理指标关联度分析、睡眠时长影响分析、呼吸率分布范围分析、打鼾频率关联分析、生理指标聚类分布和心率波动范围监
摘要:本文介绍了Spark中两个Transformation转换算子glom和foldByKey的使用案例。glom算子将每个分区的数据合并为数组,适用于数据量小且需要分区内统计的场景,文中展示了Java和Scala的代码实现。foldByKey算子则是对键值对RDD进行聚合操作,与reduceByKey类似但支持初始值设置,适用于分区内外聚合规则相同的场景,同样提供了Java和Scala示例。文
技术摘要:分布式计算的核心技术与实践 本文系统介绍了分布式计算的基本概念、关键技术及实现方法。主要内容包括: 核心概念:分布式计算通过任务分解与并行处理突破单机性能限制,具备并发性、分布性、自治性等特征。 关键技术: 通信机制:消息传递模型与RPC远程调用 一致性协议:Raft选举算法实现(含状态机示例代码) 协调服务:ZooKeeper等工具的应用 实践示例: 提供Python实现的Socket
本文介绍了一个基于Python大数据技术的火锅店数据可视化分析系统,采用Spark、Hadoop、Django等技术框架开发。系统包含三大核心模块:1)市场宏观分析模块,通过价格区间、城市密度等维度分析市场态势;2)店铺竞争力评估模块,运用评分分析构建竞争力模型;3)经营策略优化模块,通过K-means聚类算法实现用户满意度分析。系统旨在帮助餐饮从业者从经验驱动转向数据驱动的决策模式,提供市场定位
本文介绍了Spark中常用的Join和Union转换算子。Join操作包括join、leftOuterJoin、rightOuterJoin和fullOuterJoin,用于基于键合并两个K-V格式的RDD,类似于数据库连接操作,结果RDD的分区数与父RDD中分区数较多的相同。Union操作用于合并两个类型相同的RDD,不会去重,结果RDD的分区数是两个RDD分区数的总和。文章提供了Java和Sc
在大数据系统中,关于海量数据之间的传输方法是面临的首要困难,为了解决大数据集的传输困难,就必须要构建一个消息系统。一个消息系统负责将数据从一个应用程序传递到另外一个应用程序中,应用程序只关注数据,无需关注数据在多个应用之间是如何传递的,分布式消息传递基于可靠的消息队列,在客户端应用和消息系统之间异步传递消息。消息系统有两种主要的消息传递模式,分别是点对点消息传递模式和发布订阅消息传递模式。
Spark on K8s 部署实战:云原生大数据架构解析 本文深入探讨 Spark 在 Kubernetes 上的部署方案,通过架构解析、环境搭建和 RBAC 配置,实现从传统 YARN 到云原生的技术升级。核心内容包括: 架构优势:Spark on K8s 采用无 ApplicationMaster 设计,Driver 直接与 API Server 交互,实现 Pod 级资源隔离和弹性伸缩 环境
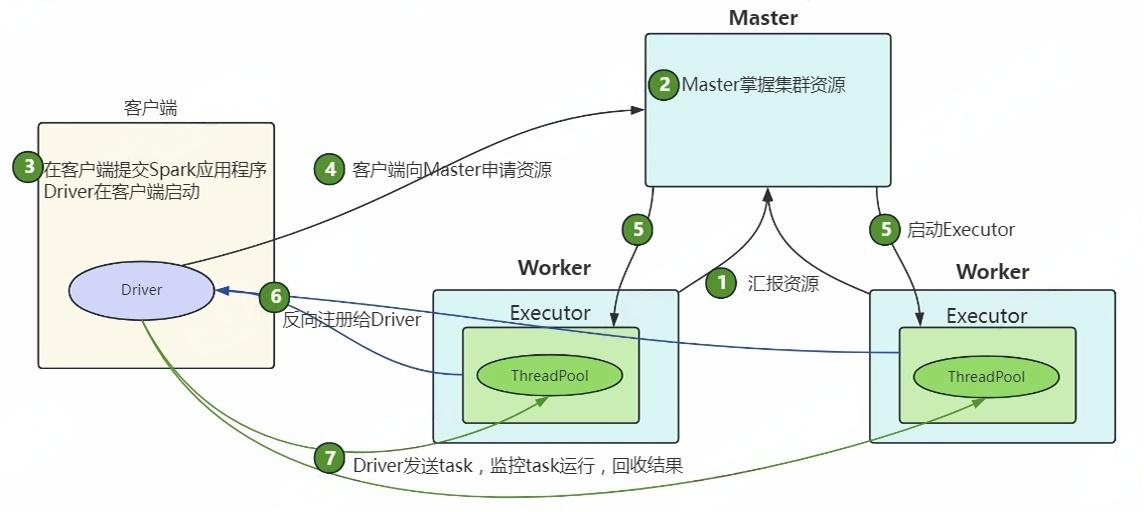
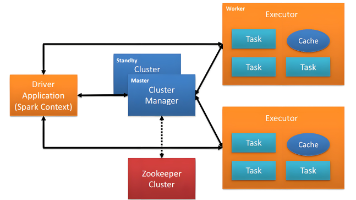
Spark 的世界就像一场大型协作演出:Driver 负责指挥全局,Cluster Manager 分配资源,Worker 和 Executor 则在后台默默干活。每个 RDD 分区都化身为并行 Task,在集群上同时运行。理解它们的分工与协作,你就能看懂 Spark 的“分布式魔法”是如何高效驱动数据计算的。
第一部分 Spark核心概述-Spark是什么
本文介绍了一个基于Django框架的热门旅游景点数据分析系统的设计与实现。系统采用Python3.8开发,MySQL5.7作为数据库,使用Navicat12和PyCharm进行开发管理。系统功能包括门票信息管理、民宿信息管理、系统管理等模块,采用B/S架构实现可视化分析看板。关键技术包括Python解释型语言特性、Django框架的MVT模式、Vue前端框架等。通过系统测试验证了系统在功能、性能等
本文介绍了一个基于Python和Hadoop的电信客户特征可视化分析平台,该系统利用Hadoop平台处理海量电信数据,通过客户流失分析、消费行为分析、服务使用分析、客户特征分析等核心模块,帮助企业优化客户服务策略。平台采用数据仪表板实时展示关键指标,并提供新闻资讯模块支持行业动态。文章展示了系统页面设计效果,并附有核心代码片段(数据加载和分析功能)。该系统可提升电信企业的数据分析能力,通过精准预测
Spark是一款分布式内存计算的统一分析引擎。其特点就是对任意类型的数据进行自定义计算。Spark可以计算:结构化、半结构化、非结构化等各种类型的数据结构,同时也支持使用Python、Java、Scala、R以及SQL语言去开发应用程序计算数据。Spark的适用面非常广泛,所以,被称之为 统一的(适用面广)的分析引擎(数据处理)RDD 是一种分布式内存抽象,其使得程序员能够在大规模集群中做内存运算
本文介绍了一个基于Spark的眼科疾病临床数据可视化分析系统,通过大数据技术提升眼科疾病的诊断、治疗和预防效率。系统整合Python、Hadoop、Vue等技术,实现患者特征分析、疾病分布统计、治疗方案评估等功能,并通过Echarts进行可视化展示。研究背景强调传统人工处理数据的局限性,而本系统通过自动化分析为医疗决策提供科学依据,具有重要的社会与科研价值。系统包含多模块功能设计,并附有页面效果图
突破传统Hive单一数据源限制,支持RDD、Parquet、JSON、CSV、JDBC(如MySQL/Oracle)等异构数据源,形成统一抽象的数据帧(DataFrame)接口。Spark SQL的核心价值在于以SQL语法统一异构数据处理流程,通过Catalyst与Tungsten的深度协同,使开发者无需关注底层分布式复杂性,专注业务逻辑实现。摆脱对Hive执行引擎的依赖(仅复用其元数据存储与HQ
本文深入探讨了Spark框架的核心问题与优化策略。首先介绍了性能优化的关键方法,包括资源配置、数据处理、算子优化等方面。针对常见的数据倾斜问题,详细分析了其成因和解决策略。文章还解析了RDD的宽窄依赖特性,列举了各类核心算子的使用场景与原理,并阐述了RDD的五大核心特性。此外,还总结了会产生shuffle操作的算子类型,比较了repartition和coalesce的异同点及其适用场景。最后,详细
SparkSQL提供了统一的数据加载与保存方式,支持多种文件格式(Parquet、JSON、CSV等)和JDBC数据源。通过spark.read.load和df.write.save通用API,配合format和option参数可灵活处理不同格式数据。其中Parquet是默认格式,支持列式存储;JSON文件需每行为一个JSON串;CSV可配置分隔符和表头;MySQL数据通过JDBC读写,需指定连接
本文介绍了Spark在Yarn模式下提交任务的两种方式:Yarn-Client和Yarn-Cluster模式。Yarn-Client模式中,Driver运行在客户端节点,适合测试环境;Yarn-Cluster模式中,Driver作为AM运行在集群内部,适合生产环境。文章详细说明了两种模式的提交命令和执行流程,并对比了它们的特点和使用场景。Yarn-Client模式便于查看任务结果但可能导致客户端负
Apache Spark 4.0 带来了 PySpark 画图、多态 UDTF、改进的 SQL 脚本和 Python API 更新,以增强实时分析和可用性。 Apache Spark 4.0 于 2025 年发布,它通过增强性能、可访问性和开发者生产力的创新,重新定义了大数据处理。在 Databricks、Apple 和 NVIDIA 等机构的 400 多位开发者的贡献下,Spark 4.0 解决
Spark,是一种通用的大数据计算框架,也正如传统大数据技术Hadoop的MapReduce、Hive引擎,以及Storm流式实时计算引擎等,Spark包含了大数据领城常见的各种计算框架:比如Spark Core用于离线计算,Spark SQL用于交互式查询,Spark Streaming用于实时流式计算,Spark MILlib用于机器学习,Spark GraphX用于图计算。而spark计算过
Spark采用主从架构,核心组件包括Driver Program、Cluster Manager、Worker Node和Executor。Driver负责分析作业并调度任务,Executor执行任务并缓存数据。作业执行流程分为DAG生成、Stage划分和Task调度,其中Shuffle机制优化数据传输效率。Spark通过统一内存管理和Tungsten项目优化内存使用,并借助血统机制和Checkp
本文深入剖析了Spark的DAG构建与Stage划分机制,以及Task调度的底层原理。主要内容包括:1) DAG构建过程基于RDD的转换操作形成逻辑执行计划,通过行动操作触发计算;2) Stage划分依据RDD依赖类型,窄依赖可管道化执行,宽依赖成为Stage边界;3) Task数量主要由RDD分区数决定,受Shuffle配置、数据源特性等影响。文章详细解析了窄/宽依赖的特点及Stage划分逻辑,
HBase数据库不同于一般的数据库,如MySQL数据库和Oracle数据库是基于行进行数据的存储,而HBase则是基于列进行数据的存储,这样的话,HBase就可以随着存储数据的不断增加而实时动态的增加列,从而满足Spark计算框架可以实时的将处理好的数据存储到HBase数据库中的需求。进入HBase Shell交互界面后,可以通过一系列Shell命令操作HBase, 接下来,通过一张表列举一些操作
在Standalone-Client模式中,Driver进程在提交Application的客户端节点上启动,客户端可以查看任务的执行情况和结果。原因在于,当客户端提交大量Application时,所有Driver都在客户端启动,Driver与集群之间存在大量通信,可能导致客户端网络流量激增。:在Standalone-Cluster模式中,Driver进程在集群的某个Worker节点上启动,客户端无
本文系统阐述了Apache Spark在大数据ETL流程中核心环节——数据清洗与数据转换的应用实践。围绕ETL基本原理,详细探讨Spark内存计算和分布式处理优势,结合典型业务场景,讲解数据抽取、清洗、转换及加载的技术要点与优化技巧。通过实例代码、对比表与流程图,帮助读者构建高效、稳定的ETL解决方案,提升大数据处理质量与性能,适合大数据工程师及开发者深入学习参考。
Sheel 是一个轻量级、易于使用且功能强大的命令行工具,它为开发者提供了一个简单直观的环境来运行各种代码和脚本。无论是进行快速原型开发,还是执行一些临时性的数据分析任务,Sheel 都能快速响应并提供支持,极大地提高了工作效率。Apache Spark 是一个开源的分布式计算框架,它能够快速处理大规模数据集。Spark 提供了丰富的 API,支持多种编程语言,如 Scala、Java、Pytho
博主介绍: ✌我是阿龙,一名专注于Java技术领域的程序员,全网拥有10W+粉丝。作为CSDN特邀作者、博客专家、新星计划导师,我在计算机毕业设计开发方面积累了丰富的经验。同时,我也是掘金、华为云、阿里云、InfoQ等平台的优质作者。通过长期分享和实战指导,我致力于帮助更多学生完成毕业项目和技术提升。技术范围: 我熟悉的技术领域涵盖SpringBoot、Vue、SSM、HLMT、Jsp
本篇博客深入探讨了数据分析与挖掘的核心技术,涵盖了大数据分析流程、数据挖掘算法和特征工程的实际应用。通过具体案例,详细解析了数据挖掘算法如何从复杂的数据中提取有价值的洞察,特征工程如何优化数据特征以提升模型性能,以及大数据分析如何高效处理海量数据,揭示其中潜在的趋势和模式。
Spark 是一个快速、通用且可扩展的大数据处理框架,最初由加州大学伯克利分校的AMPLab于2009年开发,并于2010年开源。它在2013年成为Apache软件基金会的顶级项目,是大数据领域的重要工具之一。Spark 的优势在于其速度和灵活性。相比传统的Hadoop MapReduce模型,Spark通过内存计算减少了I/O开销,使得迭代式算法(如机器学习和图计算)的性能提升显著。此外,Spa
特性SQLDataFrameDataSet类型检查运行时运行时编译时(强类型)语言支持所有语言Java/Scala适用场景简单查询复杂数据处理类型安全需求高性能相同(底层都经过Catalyst优化)Spark SQL是什么:处理结构化数据的工具,支持SQL和编程API。运行原理:SQL→解析→逻辑计划→优化→物理计划→生成代码→分布式执行。如何选择简单查询用SQL;复杂逻辑用DataFrame/D
Spark的开发工程师们考虑到了这个问题,利用SQL语言的语法简洁、学习门槛低以及在编程语言普及程度和流行程度高等诸多优势,从而开发了Spark SQL模块,通过Spark SQL,开发人员能够通过使用SQL语句,实现对结构化数据的处理。Apache Hive是Hadoop上的SQL引擎,也是大数据系统中重要的数据仓库工具,Spark SQL支持访问Hive数据仓库,然后在Spark引擎中进行统计
提供了更高级的编程接口,如 RDD(弹性分布式数据集)和 DataFrame,支持丰富的操作算子,使得开发者可以以更简洁的方式编写复杂的处理逻辑。:采用基于磁盘的处理方式,每个任务的中间结果需要写入磁盘,然后再读取进行下一步处理。:提供了相对低级的编程接口,主要包含 Map 和 Reduce 两个操作,开发者需要编写较多的代码来实现复杂的数据处理逻辑。Application运行前,为所有的Spar
Spark SQL使用的数据抽象并非是RDD,而是DataFrame。在Spark 1.3.0版本之前,DataFrame被称为SchemaRDD。DataFrame使Spark具备处理大规模结构化数据的能力。在Spark中,DataFrame是一种以RDD为基础的分布式数据集。DataFrame的结构类似传统数据库的二维表格,可以从很多数据源中创建,如结构化文件、外部数据库、Hive表等数据源。
Spark SQL是Spark用来处理结构化数据的一个模块,它提供了一个编程抽象结构叫做DataFrame的数据模型(即带有Schema信息的RDD),Spark SQL作为分布式SQL查询引擎,让用户可以通过SQL、DataFrames API和Datasets API三种方式实现对结构化数据的处理。但无论是哪种API或者是编程语言,它们都是基于同样的执行引擎,因此可以在不同的API之间进行随意
综合以上分析,我们针对不同框架的数据倾斜问题提出以下最佳实践和可操作的优化策略:Hive 离线计算设计健壮的SQL:尽量避免产生倾斜的查询模式。大表Join尽量先过滤无关数据,或者拆分步骤处理。适当使用MAPJOIN/广播小表,减少需要shuffle的数据量.启用倾斜优化参数:在Hive on MR/Tez上开启和)等,让Hive自动检测并处理倾斜键.充分利用分区和桶:数据导入Hive时设计合理分
金融行业推荐Flink+Spark组合方案,互联网行业倾向Spark+Flink技术栈,传统企业建议保留Hadoop作为数据湖基座。
SnowNLP 是一个基于 Python 的开源自然语言处理库,专注于中文文本处理,广泛应用于舆情分析等领域。以下是关于 SnowNLP 舆情算法的详细介绍:1. SnowNLP 的基本功能SnowNLP 提供了多种功能,包括中文分词、情感分析、文本分类、关键词提取、文本摘要等。在舆情分析中,情感分析功能尤为重要,它能够判断文本的情感倾向(积极、消极或中性),并给出情感得分。2. 情感分析算法原理
** 为sql字符串创建逻辑计划 */// 获取构造器AstBuilder,将ParseTree转换为AST(visit模式)case _ =>command")// 将sql内容转换成字符流,并且转换成大写形式。词法解析器// 清空识别错误的监听器// ParseErrorListener将解析错误转换为 AnalysisException。ParseException继承AnalysisExc
FlinkFlink 是一个分布式流处理框架,其架构基于流计算,将一切都看作是流。它采用了一种基于事件驱动的架构,数据以流的形式源源不断地进入系统,并且能够实时处理这些数据。例如,在实时监控网络流量的场景中,网络流量数据作为一个持续的数据流进入 Flink 系统,Flink 可以对每一个数据包(事件)进行实时分析,如检测异常流量。Flink 的运行时系统基于作业(Job)和任务(Task)的概念。
大数据的SparkStreaming Spark,mapreduce等概念