登录社区云,与社区用户共同成长
邀请您加入社区
摘要 MapReduce作为Hadoop核心计算框架,通过"分而治之"思想将大数据任务分解为并行子任务。本文系统解析MapReduce三大核心机制: MapTask执行机制:从数据分片(InputSplit)到RecordReader读取,通过Map函数处理生成中间键值对,经Combiner本地聚合后按Partitioner分区。关键优化包括减少对象创建、批量处理和合理使用Co
技术摘要:分布式计算的核心技术与实践 本文系统介绍了分布式计算的基本概念、关键技术及实现方法。主要内容包括: 核心概念:分布式计算通过任务分解与并行处理突破单机性能限制,具备并发性、分布性、自治性等特征。 关键技术: 通信机制:消息传递模型与RPC远程调用 一致性协议:Raft选举算法实现(含状态机示例代码) 协调服务:ZooKeeper等工具的应用 实践示例: 提供Python实现的Socket
本文系统介绍了MapReduce分布式计算模型的执行原理。MapReduce采用"分而治之"思想,将任务分解为Map和Reduce两个阶段:Map阶段并行处理数据分片并生成中间键值对;Shuffle阶段对中间结果进行分区、排序和聚合;Reduce阶段完成最终计算。该模型具有编程简单、并行度高、容错性强等优点,但也存在磁盘I/O依赖、迭代计算效率低等局限。虽然新兴计算框架不断涌现
API 是“Application Programming Interface”的缩写,即“应用程序编程接口”Hadoop 提供了一套,用于开发 MapReduce 程序、访问 HDFS、控制作业等MapReduce 是一种,主要用于处理。MapReduce应用程序至少包含 3 个部分:一个 Map 函数、一个 Reduce 函数和一个 main 函数。
ubantu18.04(Hadoop3.1.3)之MapReduce编程+步步截图
在实现之前我们要先知道Hadoop是什么?Hadoop 是一个开源的分布式计算框架,主要用于处理大规模数据集的存储和计算。它最初由 Doug Cutting 和 Mike Cafarella 开发,目的是为搜索引擎提供一种高效、可靠的方式来处理大量数据。Hadoop 的设计灵感来源于 Google 发表的关于分布式文件系统(GFS)和 MapReduce 论文。HDFS 是 Hadoop 的分布式
大数据的SparkStreaming Spark,mapreduce等概念
0 : 1);作用:等待 MapReduce 作业完成,并根据作业的执行结果退出 Java 程序。含义提交作业并等待作业完成。根据作业是否成功,返回0或1。用于终止程序,并传递作业的成功或失败状态。
mapreduce数据预处理及hive分析汇总【全国大数据比赛省赛赛题--mapreduce数据预处理及hive分析汇总】
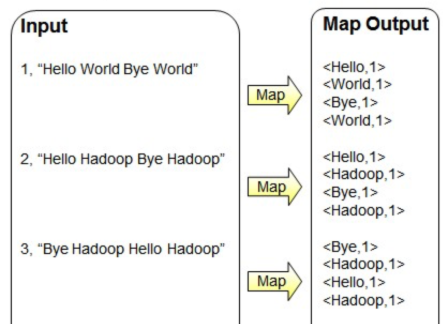
智能大数据分析实验一,MapReduce实验:单词计数。基于MapReduce思想,编写在Hadoop中依赖Yarn框架执行的MapReduce程序,并在Linux系统中运行程序,实现单词计数。