登录社区云,与社区用户共同成长
邀请您加入社区
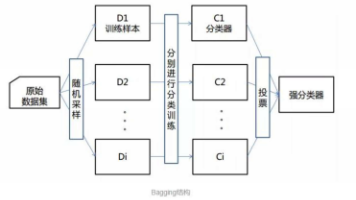
集成学习是将多个基学习器(基础模型)进行组合训练,最终形成一个强学习器的机器学习方法,核心思想是“三个臭皮匠,顶个诸葛亮”——通过多个简单模型的协同,实现比单一模型更优越的学习性能。随机森林是以决策树为基分类器的Bagging集成模型,通过对训练数据和特征进行双重随机采样,构建多棵相互独立的决策树,最终通过多数投票(分类任务)或均值(回归任务)得到模型输出。其核心是“随机”+“森林”:随机保证了树
解决回归问题的决策树模型你就是回归树回归树是一种基于决策树的监督学习算法,用于解决回归问题。通过递归地将特征空间划分为多个子区域,并在每个子区域内拟合一个简单的预测值(如均值),实现对连续目标变量的预测。
决策树是一种基于树结构的分类模型,通过信息熵、信息增益、信息增益率和基尼系数等指标进行特征选择与数据划分。本文以天气数据为例,详细计算了信息熵(H(S)=0.940)、信息增益(天气特征增益最大为0.2467),并针对多值特征问题引入信息增益率(天气特征增益率0.156)。同时演示了基尼系数的计算(初始Gini=0.459),说明不同分裂准则的差异。通过Python代码实现了关键指标的计算,揭示了
决策树是一种模拟人类决策过程的树形结构,常用于分类和回归任务。核心算法包括ID3(信息增益)、C4.5(信息增益率)和CART(基尼指数)。决策树通过计算特征的信息熵、基尼指数等指标选择最优分裂点,具有可解释性强、无需特征缩放等优点,但容易过拟合。可通过预剪枝和后剪枝技术提升泛化能力。在泰坦尼克生存预测和房价预测等案例中,决策树展现了良好的性能。实际应用中需注意连续特征处理和过拟合问题。
从决策树的核心算法(ID3、C4.5、CART)讲起,带你理解连续值处理、剪枝策略
对于一个离散随机变量XXX,其可能取值为x1x2xnx1x2...xn,对应的概率分布为p1p2pnp1p2...pnHX−∑i1npilog2piHX−i1∑npilog2pi其中,piPXxipiPXxi表示随机变量XXX取值为xix_ixi的概率。给定随机变量XXX和YYYXXX在YY。
ID3 需要评估每个属性的信息增益。基尼指数衡量数据集的不纯度GiniS1−∑j1kPj2GiniS1−j1∑kPj2PjP_jPj是类别jjj在数据集SSS中的比例。基尼增益ΔGiniGiniS−∣SL∣∣S∣GiniSL∣SR∣∣S∣GiniSRΔGiniGiniS−∣S∣∣SL∣GiniSL∣S∣∣SR∣Gini。
神经网络 需求预测 图像识别 人脸识别 层 前向传播 TensorFlow 激活函数 ReLU 多类别分类 Softmax回归 多标签分类 高级优化方法 Adam算法 密集层 卷积层 模型评估 偏差与方差 正则化 学习曲线 误差分析 数据增强 数据合成 迁移学习 倾斜数据集 精确率 召回率 F1 Score 决策树 信息增益 独热编码 回归树 树集成 随机森林 XGBoost 梯度提升
待测试的超参数params = [params是一个列表,其中每个元素是一个字典,包含了决策树回归模型的超参数组合,包括criterion(分裂准则)和max_depth(树的最大深度)。
在当今这个数据驱动的时代,机器学习作为数据分析与预测的利器,正以前所未有的速度改变着我们的生活和工作方式。在众多机器学习算法中,决策树算法以其直观易懂、高效实用的特点,成为了众多领域不可或缺的工具。本文旨在带领读者深入探索机器学习决策树算法的奥秘,从基本原理到实践应用,全面剖析这一经典算法的魅力所在。
决策树(Decision Tree)是一种分类和回归方法,是基于各种情况发生的所需条件构成决策树,以实现期望最大化的一种图解法。由于这种决策分支画成图形很像一棵树的枝干,故称决策树。它的运行机制非常通俗易懂,因此被誉为机器学习中,最“友好”的算法。决策树由结点和有向边组成。结点有两种类型:内部结点(圆)和叶结点(矩形)。其中,内部结点表示一个特征(属性);叶结点表示一个类别。而有向边则对应其所属内
决策树是一种常见的机器学习算法,用于分类和回归任务。它的工作原理是通过一系列的判断条件来对数据进行分割,直到达到某个终止条件在实际应用中,决策树通常需要配合剪枝技术来提高其在未知数据上的泛化能力。此外,决策树也可以作为集成学习方法(如随机森林、梯度提升树)的一部分,以提高模型的性能总的来说,随机森林是决策树的一种扩展,它通过集成多个决策树来提高预测性能和模型的稳定性这个实例展示了如何使用Pytho