登录社区云,与社区用户共同成长
邀请您加入社区
综上,霍夫变换凭借「图像空间与参数空间对偶映射+累加投票」的核心逻辑,成为直线、圆这类规则几何形状检测的经典技术,也是本次分享的核心内容。直线检测核心通过极坐标方程(ρxcosθysinθρxcosθysinθ)规避了直角坐标下垂直线斜率无穷大的缺陷,经「边缘预处理→空间映射→累加投票→峰值检测」四步,即可鲁棒提取图像中的直线;圆检测核心拓展至三维参数空间(圆心x、圆心y、半径r),通过对圆心
本文系统介绍了OpenCV图像处理的核心技术,主要包括三大部分:1. 阈值处理:详细讲解五种二值化分割方法(THRESH_BINARY、THRESH_BINARY_INV等)的原理、API参数及实际应用场景;2. 图像平滑:分析四种滤波技术(均值、高斯、中值、方框)的特点、适用场景及代码实现,并给出选型建议;3. 形态学操作:涵盖基础操作(腐蚀、膨胀)、组合操作(开闭运算)及进阶操作(梯度、顶帽、
本文介绍了基于OpenCV的C#图像分割技术,重点讲解了分水岭算法的实现流程。主要内容包括:图像预处理(灰度化、二值化、开运算)、背景/前景图设置(使用膨胀和DistanceTransform算子)、边缘图计算、标识图构建(ConnectedComponents处理)以及最终的分水岭分割(Watershed算法)。文章提供了详细的OpenCV函数调用示例和效果展示图,并分享了相关的视觉工具下载链接
本文介绍了数字图像处理中表示与描述的核心方法,包括边界跟踪、链码、多边形逼近、骨架提取等表示方法,以及边界描述子、区域描述子、关系描述子等特征提取技术。通过Python代码实现并对比了各种方法的实际效果,如Freeman链码压缩边界数据、傅里叶描述子保持形状特征、Hu矩的平移旋转不变性等。文章还提供了工程应用建议,如简单形状识别推荐使用Hu矩或傅里叶描述子,纹理分析适合灰度共生矩阵。所有案例均附带
YOLOv5解析:PyTorch时代的工程化典范 YOLOv5是Ultralytics公司于2020年发布的基于PyTorch的目标检测框架,尽管存在命名争议,但其工程化实现、易用性和活跃社区使其成为最流行的检测框架之一。主要特点包括: 模块化架构:采用Focus模块(后改为6×6卷积)、CSP结构和SPPF模块,平衡性能与速度 多尺度模型:提供5种规模的预训练模型(n/s/m/l/x),参数从1
本文摘要:《数字图像处理》第12章系统讲解了图像模式分类的理论与方法。首先介绍了模式分类的基本概念和发展历程,包括传统手工特征、浅层神经网络和深度学习三个阶段。重点阐述了四种典型分类方法:原型匹配(最小距离、互相关、SIFT特征匹配、结构匹配)、贝叶斯统计分类器、神经网络(感知机、多层前馈网络)和深度卷积神经网络(CNN)。通过MNIST手写数字分类等实例,详细推导了各类算法的数学原理,并提供了完
基于阈值分割的车牌定位识别
OpenCV 是全球最流行的开源计算机视觉库,提供超过 2500 个优化算法,支持图像处理、视频分析、物体检测、增强现实和机器学习等功能。本文将带你深入了解 OpenCV 的核心概念、安装方法、常用功能以及应用案例,并结合 Python 实操示例,让你快速上手计算机视觉开发。
本文介绍了一个用Rust实现的二维码艺术生成器项目(qr-artist),旨在将功能性二维码转化为美观的艺术作品。项目使用Rust语言结合qrcode、image和clap等库,实现了多种像素样式(方形、圆形、圆角矩形)、彩色支持和彩虹效果。具体功能包括基础二维码生成、自定义像素样式、智能颜色生成算法和彩虹效果渲染。文章展示了不同风格的生成示例,并强调了艺术化设计时需注意对比度、清晰度等原则。该项
本文针对巡检机器人在户外环境下的视觉识别准确率低和误报警问题展开研究。通过分析发现,自然环境变化(季节、天气、光线)和工业场景复杂性(设备位置不确定、故障多样性)是主要挑战。研究提出自动优化的数据采集识别模式,通过时间序列图像对比分析环境变化,结合深度学习进行特征提取和异常判断。在某化工园区的应用验证表明,该模式将气体泄漏识别准确率从60%提升至85%以上,误报率从35%降至10%以下。未来研究可
灰度图中每个像素的值 ( I(x, y) \in [0, 255] ) 可视为该点的“浓度”。
摘要:本发明公开了一种基于自适应权重多图像融合算法的图像处理方法,通过卷积处理、位置对齐、过曝/欠曝区域筛选、合并归一化等步骤,实现多张图像的智能融合。该方法能有效保留图像细节、降低噪声、增强局部对比度,最终生成边缘清晰、表面柔和的优质融合图像。关键技术在于自适应权重计算,根据像素距离平均灰度值的标准差动态调整融合参数,解决传统融合方法细节丢失和噪声干扰问题。该技术可广泛应用于图像处理领域,显著提
YOLOv3是一种高效的单阶段目标检测算法,通过单次前向传播即可预测目标位置和类别。其核心框架采用Darknet-53主干网络,结合特征金字塔结构输出13×13、26×26、52×52三种尺度的检测结果,分别对应大、中、小目标的检测。每个网格预测3个边界框,使用预定义的锚框和偏移量计算实现高效定位。网络通过255个通道输出(85×3),包含80个类别概率、4个坐标偏移和1个置信度。
二值化,就是将图像从彩色或灰度模式转换为只有两种颜色(通常是黑色和白色)的模式。这个过程的本质是设定一个,将图像中所有像素的灰度值与这个阈值进行比较。经过上述处理后,图像中的所有像素都只剩下两种可能的值:0 和 255,从而得到了一个黑白分明的二值化图像。二值化是许多图像处理和计算机视觉任务中的一个重要预处理步骤。选择阈值是二值化的核心挑战。错误的阈值会导致信息丢失或引入噪声。
本文介绍了基于OpenCV的机器人视觉目标检测方法,重点讲解了Hough变换在圆形检测中的应用。文章首先概述了机器人视觉中目标检测的意义及常用方法,包括传统图像处理和深度学习技术。随后详细阐述了Hough变换的原理及其圆形检测算法流程,并提供了完整的Python代码示例,展示如何通过OpenCV实现图像预处理、圆形检测和结果可视化。最后讨论了该方法的局限性,并建议可结合深度学习等先进技术提升检测效
在计算机视觉领域,OpenCV 库提供了丰富的图像处理函数,助力开发者实现各类图像编辑与分析任务。本文将围绕边界填充、图像算术运算、阈值处理以及平滑滤波等核心技术,通过具体代码示例详细讲解其实现方法与应用场景。
图像形态学处理是一种基于形状的图像分析技术,主要通过腐蚀、膨胀及其组合操作来增强或提取图像特征。核心操作包括腐蚀(缩小前景区域)、膨胀(扩大前景区域)以及开运算(先腐蚀后膨胀,去除小物体)和闭运算(先膨胀后腐蚀,填充孔洞)。高级操作如形态学梯度用于边缘检测,顶帽变换用于提取亮/暗细节。这些操作通过结构元素(如矩形、圆形)控制处理效果,广泛应用于噪声消除、特征提取和图像增强等领域。OpenCV提供了
摘要:本文介绍了两种图像分割方法:彩色图像分割和GrabCut算法。彩色图像分割利用颜色特征(RGB、HSV、Lab等色彩空间)通过cv2.inRange()和cv2.bitwise_and()函数实现目标提取,并讨论了光照变化等常见问题的解决方法。GrabCut算法则基于高斯混合模型,通过用户交互式选择ROI区域,结合图割理论实现精确的前景提取。两种方法均附有OpenCV实现代码,适用于人像抠图
该函数用于创建一个 CUDA 加速的 Canny 边缘检测器对象(CannyEdgeDetector),可以在 GPU 上高效执行 Canny 边缘检测算法。它返回的是一个智能指针 Ptr<CannyEdgeDetector>,可以通过这个指针调用 .detect() 方法来对图像进行边缘检测。
该函数执行 线性融合(加权平均) 两个图像 img1 和 img2,使用对应的权重图 weights1 和 weights2。
本文介绍了如何使用C#语言实现OCR(光学字符识别)功能,主要针对习惯使用C#开发的程序员。文章首先提到,虽然大多数OCR功能使用Python开发,但C#开发者可以通过特定工具和库实现类似功能。开发要求包括使用图形处理库Clipper和Emgu.CV、高性能推理引擎Microsoft.ML.OnnxRuntime,以及借用PaddleOCR模型。现有功能包括照片识别、截图识别和PDF文件识别。
参数空间中,相交在一点的直线越多,说明在直角坐标系中,有越多的点构成直线。累加器值表示有多少个点共线。通过寻找参数空间中累加器值的局部极大值,可以检测出直角坐标系中的直线。然而对于x=1这种直线(垂直于x轴)来说,y已经不存在了,斜率无穷大,无法映射到霍夫空间中去,那么就没办法使用上面的方法进行检测了,为了解决这个问题,我们就将。
是能够完全包含目标轮廓的最小面积的矩形,它允许矩形相对于图像坐标轴旋转,因此可以更好地贴合轮廓的形状,相比普通外接矩形(轴对齐的外接矩形),它可以更精确地描述轮廓的形状和方向。其基本原理是通过计算轮廓点集的最小面积矩形,这个矩形的边不一定与图像坐标轴对齐。它需要找到一组四个点,使得这四个点构成的矩形能够包含所有轮廓点,并且面积是所有可能的包含该轮廓的矩形中最小的。
模板匹配是OpenCV中的一种图像处理技术,用于在一幅图像中查找与给定模板或样本图像最相似的区域。
全国大学生智能车赛摄像头开源:提速的一些方案:动态权、模糊PID、速度决策、路径优化
本文讨论了在推理大模型时代,出版机构的非结构化数据资产迎来新机遇,TextIn ParseX助力出版业知识资产重构及数据价值释放。关键要点包括:技术浪潮带来机遇、知识资产重构关键环节、TextIn文档解析优势、数据价值释放路径等。
深度学习与实时图像分类
你仅需提供简单的几个提示词,即可快速高效帮你生成更为丰富的提示词并生成满意的图片或者视频。无论是为了创作艺术作品、设计商业宣传素材,还是满足个人兴趣爱好等,都能快速将脑海中的想法转化为逼真的图片或生动的视频。
图像噪声是指在图像中随机出现的、与图像信息无关的像素值变化,它可能来源于传感器噪声、电路噪声、传输错误或环境干扰等。噪声的存在不仅影响图像的视觉效果,还可能干扰后续的图像处理任务,如边缘检测、特征提取等。图像噪声处理是提升图像质量的关键步骤,不同的去噪方法各有千秋,选择合适的策略至关重要。随着深度学习技术的发展,基于卷积神经网络(CNN)的去噪方法正展现出强大的潜力,未来图像去噪技术将更加智能化、
数字图像处理实验二学习
DocFlow 是 TextIn 旗下的一款先进的文档自动化处理工具,专为企业提供文档分类与关键要素提取的一站式解决方案。依托于 TextIn 行业领先的文档解析与理解能力,DocFlow 能够轻松处理全球范围内各类文档类型与复杂版式,无论是票据、卡证,还是合同、文件,均可实现高精度的分类与关键要素提取,并快速整合至业务流程中。
卷积神经网络(Convolutional Neural Networks,CNN)是深度学习的代表算法之一,在深度学习中占据着重要地位。CNN 的发展历程可追溯至 20 世纪 80 至 90 年代,时间延迟网络和 LeNet - 5 是最早出现的卷积神经网络。随着深度学习理论的提出和数值计算设备的改进,CNN 在 21 世纪后得到了快速发展,并被广泛应用于计算机视觉、自然语言处理等领域。CNN 的
使用深度学习算法来分析医学影像(如X光、CT扫描、MRI),帮助医生更快、更准确地做出诊断。:图像处理技术在自动驾驶汽车中至关重要,用于识别路标、行人和其他车辆。:通过机器学习分析监控视频,实时检测异常行为或可疑活动,提高安全性。:在身份验证和安防领域广泛应用,尤其在金融服务和个人设备解锁中。:利用图像处理技术提升用户体验,实现更沉浸的互动环境。
在科技日新月异的今天,机器学习与成像技术的融合正引领着一场前所未有的智能视觉革命。随着大数据的蓬勃发展和计算能力的显著提升,机器学习不再仅仅是学术界的研究热点,它正逐步渗透到我们生活的每一个角落,特别是在成像技术领域展现出了巨大的潜力和价值。
智能车浅谈 ——图像处理篇,解析总钻风和神眼这类灰度摄像头的使用原理,结合OPENCV来梳理整个图像获取、二值化、压缩、巡线原理。
本项目成功设计并实现了一个基于STM32的车牌识别系统,通过软硬件结合的方式,展示了工程技术人员在实践能力培养方面的重要性。系统的主要目标是自动识别车辆的车牌信息,并具备良好的实时处理能力,适用于智能交通管理、停车场管理等多个领域。
这个脚本演示了如何使用HALCON软件进行文本识别,包括如何设置参数以查找特定类型的文本,如何获取和显示识别结果。脚本中使用了多个HALCON函数来完成这些任务。
对于图像处理的调试,使用具有图形用户界面(GUI)且支持实时调整和预览的图像处理软件,可以大大提高工作效率。
opencv使用BGR作为默认的颜色空间,显示图片时需要转换成RGB。反转:对于每一个像素点,黑变白,白变和。对每一个像素点应用灰度转换函数。灰度拉伸:增加相邻像素的灰度差别。灰度压缩:减少相邻像素的灰度差别。伽马矫正:灰度的指数变换映射。
在图像处理中,锐化操作用于增强图像的边缘和细节,使图像看起来更清晰。常见的图像锐化方法包括非锐化掩模(Unsharp Masking)和拉普拉斯滤波器(Laplacian Filter)。
OpenCV 的全称是 Open Source Computer Vision Library,是一个跨平台的计算机视觉库。OpenCV 是由英特尔公司发起并参与开发,以 BSD 许可证授权发行,可以在商业和研究领域中免费使用。OpenCV 可用于开发实时的图像处理、计算机视觉以及模式识别程序。该程序库也可以使用英特尔公司的 IPP 进行加速处理。OpenCV 用 C++语言编写,它的主要接口也是
Python深度学习:OpenCV图像处理实战HSV处理,图像旋转平移(读书笔记)
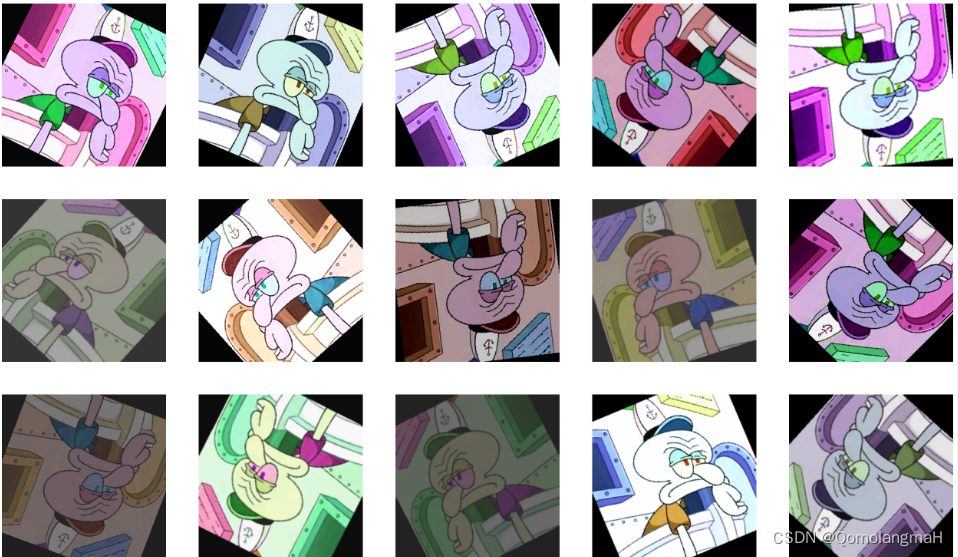
本实验介绍了通过PIL库完成图片生成、合成、添加文字等操作,并分别使用PIL和PyTorch中的transforms模块实现图像增强功能。