登录社区云,与社区用户共同成长
邀请您加入社区
分析订单时,你需要关联用户表获取用户画像计算转化率时,你需要 Join曝光表和点击表生成报表时,你需要连接事实表和多个维度表跨表 Join 是数据分析的核心能力,也是性能优化的最大挑战。查询从秒级变成分钟级网络传输暴涨,拖垮整个集群数据倾斜导致某些节点成为"热点"Doris 提供了多种 Join 策略,每种都有独特的适用场景。今天,我们从策略原理到实战优化,完整拆解 Doris 的跨表 Join
摘要:本文介绍了Yupureki的个人专栏项目——高并发内存池的优化方案。针对PageCache锁竞争严重的性能问题,采用Google TCMalloc中的基数树(Radix Tree)数据结构进行优化,通过读写分离机制避免了线程竞争。文章详细展示了基数树的三种模板实现(单层、双层、三层数组),并提供了性能测试代码对比优化前后的malloc/free效率。项目完整代码已开源在GitHub,适用于3
本文分享了基于SpringAI开发多租户AI客服SaaS平台的实战经验。重点解决了多租户隔离、流量控制、性能优化等核心挑战:1)采用ThreadLocal实现租户上下文动态切换,结合Redis多数据库隔离方案;2)通过Resilience4j实现租户级限流和熔断;3)利用FreeMarker支持租户自定义Prompt模板;4)通过缓存优化、分表设计提升并发性能。文章提供了生产可用的代码示例,并展示
本文系统介绍了Flask工厂模式与蓝图架构的最佳实践。从单体应用痛点出发,详细解析了工厂模式的实现原理、配置管理和扩展初始化顺序。通过电商平台实战案例,展示了模块化项目结构、数据模型设计和测试策略。针对企业级应用需求,提供了性能优化、监控排查和常见问题解决方案。文章最后总结了架构原则、代码规范和性能建议,并推荐了相关学习资源。全文基于作者多年Python开发经验,强调在灵活性与可维护性间取得平衡,
SpringBoot接口在生产环境中易因数据、业务、配置等问题出现响应延迟,本文摒弃代码与公式,基于Spring官方文档及工业界实战经验,拆解瓶颈定位方法、分层优化方案、实战案例及避坑要点,提供可落地的系统性优化思路,助力开发者将接口响应从秒级提升至毫秒级。
SQL版本执行时间子查询次数更新行数关键特征原始SQL(无索引)1h59m69,080次69,080每行全表扫描原始SQL(有索引)10.9秒69,080次69,080每行索引扫描(循环未减)第一版优化(LEFT JOIN)5.88秒1次69,080聚合一次,但冗余表扫描第二版优化(INNER JOIN)3.00秒1次59,430聚合一次,仅更新有端口设备第三版优化(INNER JOIN + 过滤
root@nginx ~]# echo "抱歉,你要访问的页面辞职了" > /usr/local/nginx/errorpage/errormessages。
这样做其实存在一个逻辑错误,我们先按部门分组,然后一个部门中又按照岗位分组,最终分出来的这个组中,它们的所属部门一定是一样的,并且岗位是一样的。假设有一个销售表,包含每个员工的销售额。拆分成了多张子表,在这些子表内,我们就可以直接统计它的诸如最大值,平均值这些聚合的统计,不就变成上面我们一开始学的内容了)。根据部门编号去分组,由于有多个不同的部门(对应多个不同的部门编号),所以最终就分成了多个不同
在 KingbaseES 数据库里,SQL 执行计划好不好,直接决定了查询速度快不快!优化器能选出最优计划,全靠**统计信息**这个“关键依据”——要是统计信息缺了、过时了或者不准,优化器就跟“瞎猜”没啥区别,要么选错扫描方式,要么估错结果集大小,最后导致 SQL 执行效率拉胯。今天咱就从统计信息的基础逻辑唠起,拆解自动收集、主动收集、扩展统计这些核心调优手段,再配上实打实的实战代码,帮你把统计信
Spring Boot 启动性能优化实战指南 在云原生时代,秒级启动成为刚需。本文从全链路视角剖析如何将Spring Boot启动时间从5s优化至1s: 依赖瘦身 排除冗余自动配置(如DataSourceAutoConfiguration) 引入spring-context-indexer减少类扫描耗时 延迟初始化策略 对非核心Bean使用@Lazy注解 权衡全局延迟初始化利弊 监控与调优 通过A
用户要求对 Redis 实例 redis-147885f8 进行性能优化,启用 Redis 7.2 的 I/O 多线程功能,并验证优化效果。单线程模式 (传统):│ 主线程: 接收 → 解析 → 执行 → 响应 ││ (全部串行执行) │多线程模式 (Redis 7.2):│ 主线程: 接收 → 解析 → 执行 ││ ↓ ││ I/O 线程池: 并行读取/写入响应 │。
本文以国科安芯AS32S601系列RISC-V架构微控制器为研究对象,分析其面向辐照环境与高电磁干扰场景下MCU的抗干扰设计技术体系,揭示了该型MCU在抗单粒子锁定(SEL)阈值、总剂量耐受能力及功能安全架构方面的技术特征,并进一步探讨了该架构在电机控制应用中的电磁兼容设计策略,为相关领域的工程实践提供理论参考。脉冲激光试验报告指出,在1585pJ(等效LET值65 MeV·cm²·mg⁻¹)激光
React.memo是React的高阶组件,用于函数组件的浅层记忆化,当props未变化时避免重复渲染。它通过浅比较props来优化性能,但需注意对象/数组的引用稳定性问题,可配合useMemo/useCallback使用。useCallback用于缓存函数实例,防止不必要的函数重建;useMemo则缓存计算结果,优化复杂计算场景。三者配合可有效提升性能,但应避免滥用,建议基于实际性能分析按需使用
你是否曾为数据库查询性能低下而苦恼?是否在面对复杂的SQL语句时感到无从下手?在大数据时代,数据库的性能直接关系到应用的响应速度和用户体验。今天,我们就来深入探讨SQL优化的核心技巧,从索引策略到查询优化案例,带你一步步揭开SQL性能调优的神秘面纱,让你的数据库查询如虎添翼!
单例模式(Singleton Pattern)是一种创建型设计模式,它保证一个类只有一个实例,并提供一个全局访问点来访问这个实例。场景为什么需要单例示例线程池避免重复创建线程,统一管理线程资源Spring容器整个应用只需要一个IoC容器任务调度器统一调度和管理所有定时任务全局计数器需要全局共享的计数状态网站访问计数器设备管理器管理唯一硬件设备(如打印机)全局锁管理器管理分布式锁Redis分布式锁管
在数字化浪潮席卷的今天,数据库已成为企业核心数据资产的存储中枢。无论是电商平台的订单系统、金融行业的风控模型,还是社交媒体的实时推荐,数据库的性能直接决定了业务系统的响应速度与用户体验。然而,面对海量数据与高并发场景,许多企业仍面临查询超时、锁竞争、资源耗尽等性能瓶颈。本文将从数据库工程架构设计、索引优化策略、SQL语句调优技巧三大维度,结合真实案例与代码示例,系统解析数据库性能优化的完整方法论,
Dubbo丰富的协议支持是其作为成熟微服务框架的核心竞争力之一。从面向内部高性能的dubbo://,到面向云原生和多语言的tri://,再到广泛集成的http://和grpc://,它为企业提供了灵活应对各种复杂通信场景的能力。理解这些协议的本质差异、性能特点和适用边界,能够帮助我们在微服务架构设计中做出更明智的技术决策,让每个服务间的“对话”都清晰、高效、可靠。
在 Linux 系统中,并发是常态,但并发带来的竞争条件、数据不一致问题,全靠 “锁” 来兜底。从内核态的进程调度到用户态的多线程编程,锁是保障系统稳定的核心同步原语。本文将跳出 “只会用” 的层面,深入内核源码逻辑,拆解自旋锁、互斥锁等常见锁的实现机制,剖析不同锁的设计取舍,帮你从底层理解 Linux 锁的工作原理与性能关键!
无论是枪口火焰的粒子效果,还是敌人快速移动的残影,都清晰、流畅,无拖影。文件中心真的非常适合修图、设计师,它可以直接展示本机的设备详情,可以直接拖拽和选择文件,通过设备代码或设备列表进行选择,而且这都是在同账号设备下进行的,意味着在安全保障的基础上,你可以“一传多”台设备,发挥着ToDesk无损画质、断点续传的优势。15帧率下可以勉强进行游戏,但是508ms的延时带来的非常不好的体验,即使在自身不
摘要: Ansible Roles提供了一种结构化的方式来组织变量、文件、任务等元素,通过目录分类(如tasks、handlers、vars等)实现高效代码复用。优化方面:1)性能优化包括关闭gather_facts、调整并发数、设置facts缓存(支持json和redis);2)安全优化涉及value加密、配置sudo用户替代root远程登录、结合VPN和跳板机使用。通过ansible-gala
asyncRust 提供了极高的并发性能,但也带来了“黑盒”问题。当tokio任务(Task)卡住、Future执行缓慢或Mutex锁竞争激烈时,传统的调试器(GDB)和perf(第四篇已介绍)几乎无能为力。tracing库(用于结构化、异步感知的日志)和(用于实时诊断tokio运行时的 TUI 工具),展示如何从“println!` 调试”进化到“可观测性驱动开发”。println!调试在asy
MyBatis是一款优秀的半自动化ORM持久层框架,支持自定义SQL、存储过程和高级映射。它通过代理模式简化开发,要求接口与XML文件同名且方法匹配,并支持动态SQL标签处理复杂查询。关联查询提供ResultMap和ResultType两种映射方式,同时支持延迟加载提升性能。MyBatis具备两级缓存机制(默认开启的一级会话缓存和可配置的二级Mapper缓存),并支持集成第三方缓存如Ehcache
Redisson 分布式锁的实现原理是 Redis 分布式锁的。
本文深入探讨Flutter跨平台开发框架的核心原理与工程实践。作者从技术架构、工程化落地和生产经验三大维度展开:首先解析Flutter自绘UI的渲染机制,包括Dart运行时、AOT/JIT编译模式、Skia引擎管线等底层原理;其次提供模块化项目结构设计、状态管理方案对比(Provider/Bloc/Riverpod)、性能优化等实战指南;最后分享国际化适配、CI/CD流程等生产级经验。通过架构图、
单节点Redis的死亡螺旋:真实灾难案例:解决方案:启动命令:三、Cluster模式:分布式分片之王 👑1. 数据分片原理分片公式:Slot=CRC16(key)mod 16384 \text{Slot} = \text{CRC16}(key) \mod 16384 Slot=CRC16(key)mod16384四、核心区别:10维全面对比 📊特性Sentinel模式Cluster模式胜出方
前端处理十万条数据的优化方案 摘要:当后端返回大量数据时,前端需采用多种优化策略避免性能问题。主要包括分页加载、虚拟滚动、数据懒加载、Web Workers和时间切片等技术。文中通过Vue示例展示了具体实现方案:使用分页控件管理数据展示范围,通过虚拟滚动只渲染可视区域内容,配合性能监控和时间切片技术优化渲染效率。代码示例包含了数据生成、分页逻辑、虚拟滚动实现和性能统计等功能,有效解决了大数据量场景
三层决策模型真实性能数据拓扑结构最大读QPS故障恢复时间数据丢失风险一主一从8万手动(分钟级)高一主三从24万30秒中Sentinel15万5秒低异地多活20万+秒级接近零🚀行动指南:根据业务需求选择拓扑,在下一个项目中使用Sentinel实现自动故障转移!🌟扩展阅读Redis官方复制文档。
真实案例集群分裂为两个独立分区分区A主库继续服务 → 扣款成功分区B主库也服务 → 再次扣款结果:用户被重复扣款,投诉暴增300%!fill:#333;color:#333;color:#333;fill:none;写入数据写入冲突数据主库A + 客户端A主库B + 客户端B脑裂定义:集群因网络故障分裂为多个独立子集群,每个子集群都认为自己是唯一的主库集合。部署规范节点跨机架/机房分布主从节点物理
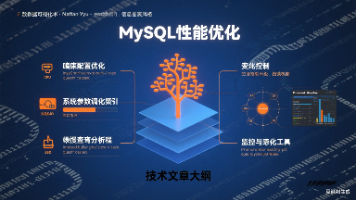
MySQL性能优化实践指南:从基础到高级全攻略 本文系统阐述了MySQL数据库性能优化的完整方法论。首先强调了优化对高并发场景的重要性,介绍了基准测试工具的选择与关键指标监控。核心部分详细解析了参数调优、索引优化和SQL语句优化三大方向,包括InnoDB缓冲池配置、索引设计原则及查询重写技巧。高级策略涉及分库分表、缓存集成和读写分离等架构优化方案。文章还提供了比赛评分标准、常见陷阱规避方法及典型优
网站体积优化、.网站传输优化、网站加载优化,8个网站性能优化逆袭方法
Redis管道技术详解:通过批量发送命令提升性能 Redis管道技术(Pipelining)是一种突破传统请求-响应模式的优化方案,允许客户端连续发送多个命令而不需等待每个响应。
EXPLAIN是分析SQL性能的关键工具,通过展示查询执行计划帮助优化数据库操作。它显示访问表的方式(全表扫描或索引)、连接算法、执行顺序和预估成本等关键信息。主要关注type(访问类型)、rows(预估扫描行数)和Extra(额外信息)等字段,其中ALL和index表示低效扫描,Using temporary和Using filesort是常见性能瓶颈。通过添加合适索引、优化JOIN和子查询等方
🌟 Spring Batch 终极指南摘要 Spring Batch是Spring生态中的企业级批处理框架,专为处理大规模数据作业而设计。核心优势包括: ✅ 健壮容错机制(跳过/重试/重启) ✅ 事务管理(Chunk级别) ✅ 元数据跟踪(执行状态持久化)
Redis使用优化笔记 Bigkey问题 定义:字符串型value>10KB或集合元素过多 风险:阻塞命令处理、网络拥塞、批量删除延迟 优化:业务拆分存储、必要字段存储、避免全量查询、分散过期时间 命令使用建议 避免全量查询命令,改用SCAN渐进式遍历 禁用危险命令(如flushall),可重命名保护 合理使用pipeline批量操作(注意非原子性) 连接池配置 关键参数:maxTotal(
本文围绕高并发系统性能优化展开,从缓存、异步、限流三个维度深入解析。在缓存策略上,对比本地缓存 Caffeine 与分布式缓存 Redis 的应用场景并给出配置示例;异步化改造结合线程池与消息队列,优化任务处理效率;限流组件选型涵盖单机 Guava RateLimiter 与分布式 Sentinel 的实践方案。通过会员活动场景展示全链路压测流程,介绍 Arthas 在性能瓶颈定位中的实战用法。优
第一范式(1 NF):字段不可再拆分。第二范式(2 NF):表中任意一个主键或任意一组联合主键,可以确定除该主键外的所有的非主键值。第三范式(3 NF):在任一主键都可以确定所有非主键字段值的情况下,不能存在某非主键字段 A 可以获取 某非主键字段 B。
类别建议高可用建议使用 Orchestrator,结合 GTID 保证切换一致性可观测性重点围绕“连接数、慢查询、IO写入、复制状态”设置告警性能优化定期进行 SQL Review,指标驱动调优策略数据安全binlog+全备,异地备份,敏感表设审计,备库设访问权限限制。
前端包部署的三种方式
要实现跨机房调用的HTTP接口并保持响应时间在80ms以下,确实面临多个技术挑战。
在计算机视觉领域,OpenCV作为开源视觉库的标杆,其性能表现直接影响着从工业检测到AI模型推理的各类应用场景。本文结合最新技术趋势与生产实践,系统性梳理Python环境下OpenCV的性能优化策略与部署方案。
本文介绍了如何优化PostgreSQL数据库的性能,重点讨论了WAL(预写式日志)、检查点、I/O性能和内存相关参数的调优方法。通过调整wal_buffers、max_wal_size、checkpoint_timeout、checkpoint_completion_target、random_page_cost、effective_io_concurrency、maintenance_work_
Nginx性能优化:从配置到缓存,全面提升Web服务器性能
虚拟线程:高并发场景首选结构化日志:生产环境必备Tiny 镜像:云原生部署标配OTLP 跟踪:微服务可观察性基石。